

A IA consegue aprender a estrutura do comportamento financeiro bem o suficiente para detectar ataques que nunca foi explicitamente treinada para identificar?
Essa é a questão por trás do Sardine AI Labs, nosso grupo de pesquisa aplicada que estuda como a IA pode aprender a linguagem do comportamento financeiro. Estamos explorando como os modelos podem aprender com sequências de atividades financeiras, transferir o que aprendem entre instituições, antecipar ataques para os quais não foram explicitamente treinados e ajudar as equipes de risco a tomar decisões melhores e mais rápidas.
Mas um melhor desempenho dos modelos é apenas parte do problema. Testamos cada avanço em relação às exigências dos sistemas de risco em produção, incluindo o desempenho de detecção, a generalização entre instituições e a inferência de baixa latência. A precisão dos modelos é avaliada em conjunto com a latência, a governança, a explicabilidade e os requisitos de supervisão humana. Estamos lançando o Sardine AI Labs com as conclusões do nosso primeiro modelo fundacional para risco de emissão, as áreas de pesquisa que exploraremos a seguir e até US$ 375.000 em bolsas para pesquisadores independentes que trabalham nos mesmos problemas.
Resolvendo os problemas mais complexos dos crimes financeiros
A próxima onda de avanços nos modelos fundacionais provavelmente virá de laboratórios de IA especializados em áreas específicas e com acesso a dados proprietários do mundo real. A prevenção de fraudes e crimes financeiros é um bom exemplo: mesmo investigadores académicos de excelência muitas vezes não têm acesso aos conjuntos de dados em grande escala necessários para fazer avançar esta área.
A prevenção de crimes financeiros também é dispendiosa, e as instituições financeiras repassam grande parte desse custo por meio de tarifas de ACH, transferências bancárias e taxas de intercâmbio de cartões. Alguns dos problemas mais difíceis nessa área continuam sem solução. Um consumidor cujo nome seja muito semelhante ao de alguém em uma lista de sanções pode ficar semanas em uma fila de integração, pois determinar se dois nomes correspondem à mesma pessoa ainda é realmente difícil. Detectar lavagem de dinheiro, financiamento do terrorismo ou tráfico de drogas em meio a bilhões de transações é igualmente difícil, razão pela qual pagamentos bloqueados e multas de milhões de dólares ainda são comuns.
Aprendendo a linguagem do comportamento financeiro
Assim como a linguagem, a atividade de pagamentos e o comportamento de acesso apresentam padrões distintos. Históricos de transações, dispositivos e endereços IP formam perfis comportamentais que os modelos fundacionais podem analisar para identificar anomalias e detectar possíveis fraudes.
A maioria dos modelos de risco começa por analisar uma transação individual e avaliar se parece suspeita. Também nos interessa perceber o que acontece quando o modelo aprende com o histórico em torno dessa transação. Um pagamento pode parecer normal quando analisado isoladamente. O seu significado muda quando se sabe o que aconteceu antes, que dispositivo o iniciou, qual é o comportamento habitual do cliente e onde esse pagamento se insere numa sequência mais longa de atividades.
Essa é a premissa por trás de grande parte do nosso trabalho no Sardine AI Labs: tratar a atividade financeira como uma sequência, e não como um conjunto de eventos isolados.
Nossa pesquisa se baseia na rede da Sardine, composta por:
- Mais de 6,5 bilhões de dispositivos analisados
- 441 milhões de identidades de consumidores
- 3,4 milhões de empresas verificadas
- 6,6 bilhões de transações analisadas
- US$ 1,8 tri em transações protegidas
Essa rede nos oferece uma ampla base para estudar como o comportamento financeiro evolui ao longo do tempo entre sessões, transações e perfis de clientes. É também por isso que estamos em uma posição privilegiada para desenvolver um modelo criado especificamente para riscos, em vez de adaptar para esse fim um modelo desenvolvido para outra finalidade.
O que aprendemos com nosso primeiro modelo fundacional para risco de emissão
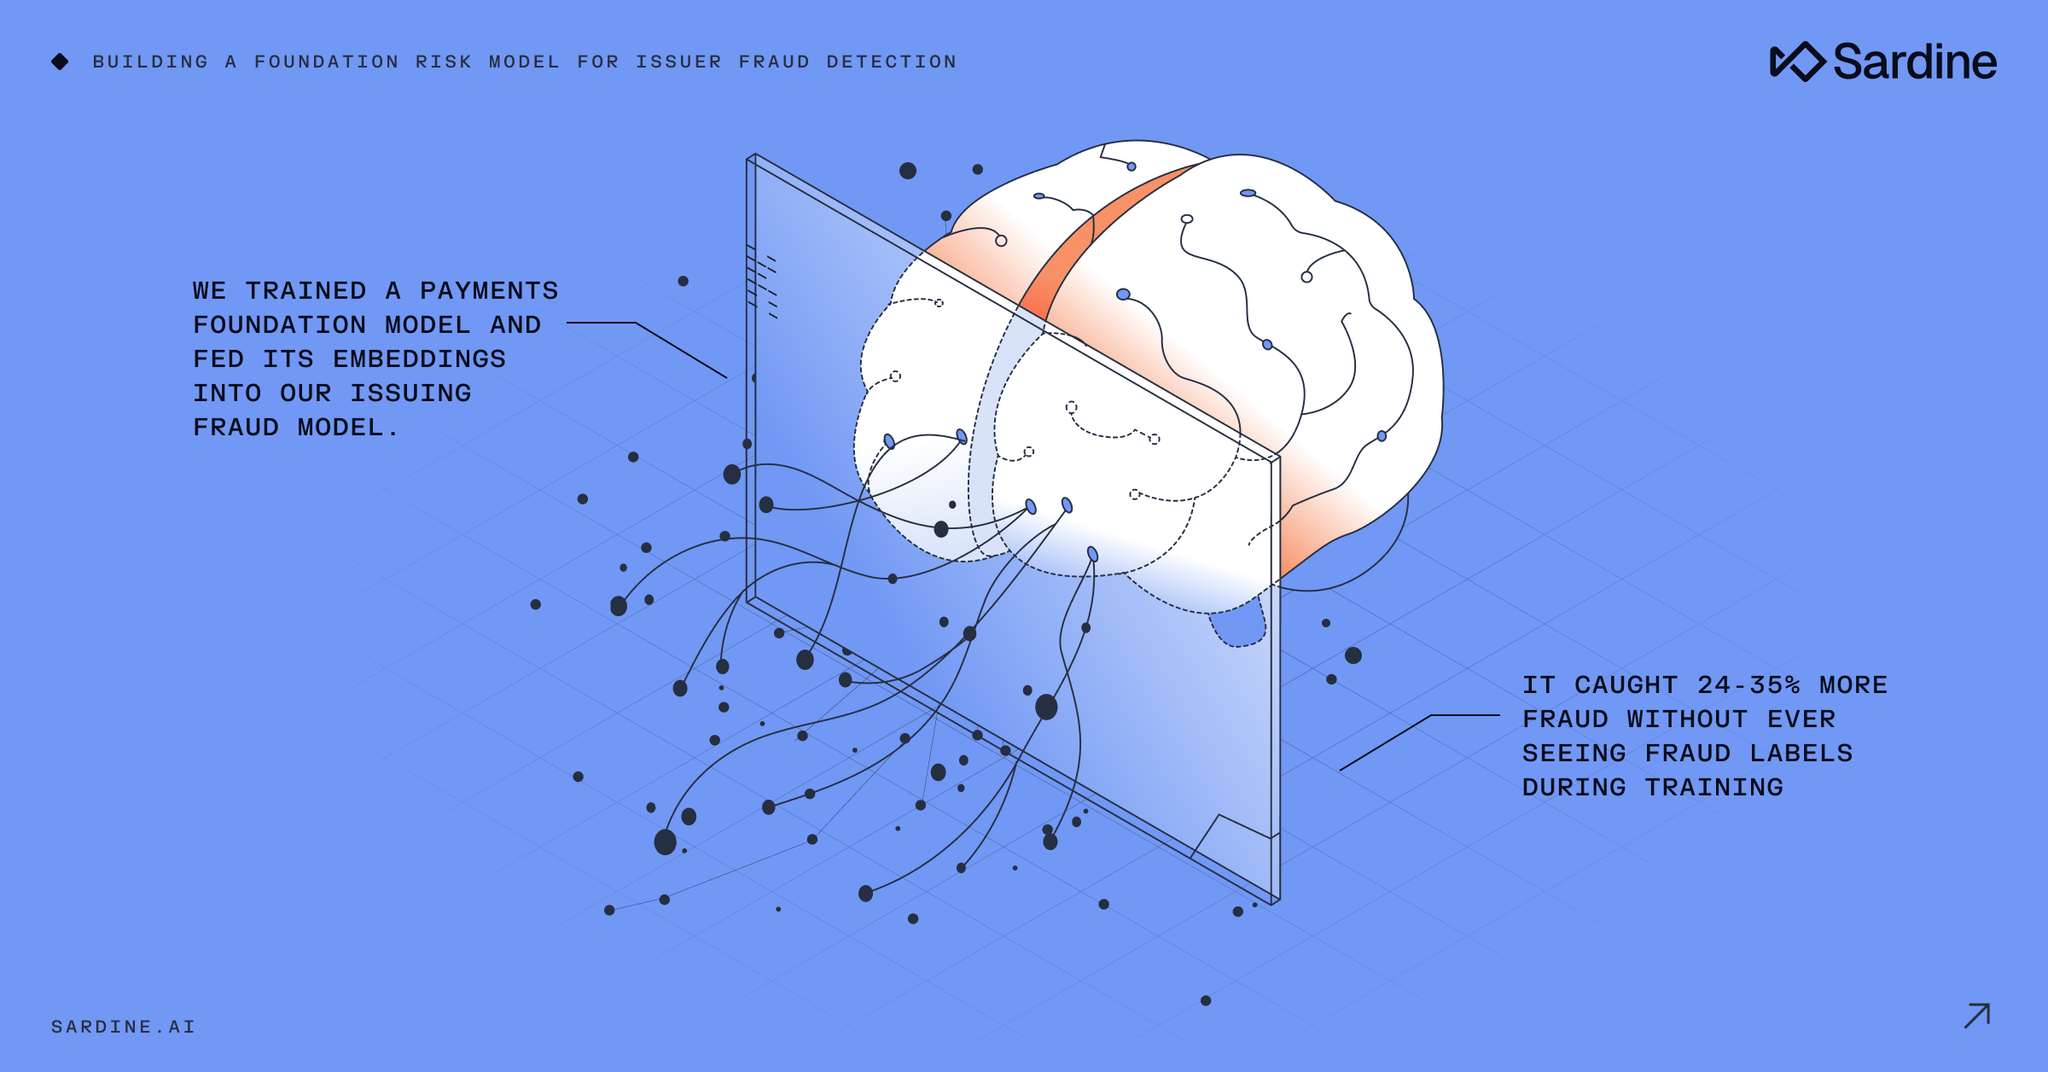
Nosso primeiro modelo fundacional para pagamentos testou uma ideia simples:
Um modelo consegue aprender representações úteis do comportamento dos titulares de cartões antes mesmo de ter acesso a um rótulo de fraude?
Em vez de ser treinado apenas com resultados de fraude rotulados, o modelo primeiro aprende com históricos de transações não rotulados. As representações aprendidas são então fornecidas como atributos ao modelo de detecção de fraudes do emissor que já está em produção. A abordagem consiste em aprender primeiro, classificar depois:
- Tokenize as informações de comerciante, valor, horário, localização geográfica, canal e terminal.
- Faça o pré-treinamento com mais de 10 meses de históricos de transações não rotulados.
- Represente o histórico de cada titular de cartão com um transformer de oito camadas.
- Combine essas características aprendidas com o modelo de fraude existente.
O modelo foi treinado com cerca de um bilhão de transações realizadas nos últimos dois anos por clientes de 13 emissores de cartões, aprendendo com os históricos completos de transações dos titulares dos cartões, em vez de reduzir esse comportamento a um conjunto estático de características.
Os resultados iniciais:
- Melhoria de 68% na precisão da detecção de fraudes (AUC-PR) para um emissor de cartões de consumo excluído do conjunto de dados de treinamento
- Melhoria de 41% na precisão da detecção de fraudes (AUC-PR) para um emissor de cartões empresariais excluído do conjunto de dados de treinamento
- 35% mais fraudes detectadas com o mesmo número de transações
Os resultados relativos ao emissor excluído do treinamento são importantes porque testam um dos problemas mais difíceis na detecção de fraudes: um modelo consegue aplicar o que aprendeu em outros contextos a uma instituição que nunca encontrou antes?
Os novos emissores de cartões enfrentam um desafio específico de arranque a frio. No lançamento, não dispõem dos dados de treino necessários para detetar fraudes de forma fiável, ao mesmo tempo que grupos de fraude procuram explorar produtos financeiros recém-lançados. Em testes com emissores totalmente excluídos do treino, o modelo apresentou melhorias entre emissores de cartões de consumo, empresariais e internacionais com operações transfronteiriças. Uma das conclusões mais importantes foi aquilo que o modelo fundacional não fez: não substituiu o modelo de fraude existente. O nosso Diretor de Ciência de Dados, Niranjan Shetty, explicou-o assim: "O resultado mais importante é que captar diretamente o comportamento transacional de um utilizador com um modelo fundacional permite-nos identificar fraudes com muito mais precisão do que condensar essa informação em atributos tabulares. Estes padrões são transferíveis entre instituições, em vez de se ajustarem a um único programa. O próximo passo é tornar essa inteligência suficientemente rápida, explicável e fiável para apoiar decisões de risco em produção."
Os embeddings aprendidos apresentaram um desempenho inferior quando usados isoladamente. O melhor desempenho foi obtido ao combiná-los com o modelo existente.
Isso aponta para um papel mais útil dos modelos fundacionais na detecção de fraudes: oferecer aos modelos de risco existentes uma representação mais rica do comportamento dos clientes, em vez de substituir toda a estrutura de gestão de riscos.
Os dados por trás do modelo
A pesquisa inicial utiliza históricos de emissão de cartões de 13 emissores em programas voltados a consumidores, PMEs, cartões de criptomoedas e bancos digitais.
A cobertura abrange o período de janeiro de 2024 a julho de 2026, com até 31 meses por emissor.
O histórico completo de cada titular de cartão é transformado numa única sequência, que pode chegar a aproximadamente 2.300 transações. Cada transação contém 14 campos fixos que abrangem comerciante, MCC, montante, momento, localização geográfica, modo de entrada, contexto de presença, informações do terminal e saldo do cartão. O objetivo não é ensinar um modelo a gerar dados financeiros, mas sim aprender uma representação do comportamento que capte o que aconteceu, quando aconteceu e o que tende a acontecer a seguir.
Do desempenho em pesquisa ao desempenho em produção
Um modelo com bom desempenho offline não é necessariamente útil em um sistema de risco em produção.
O Sardine AI Labs concentra-se em transformar os avanços em IA em proteção mensurável contra crimes financeiros. Para nós, isso significa adotar, desde o início, requisitos adequados a ambientes de produção: latência em condições reais, governança e explicabilidade, e não apenas precisão em testes de referência. Nossa pesquisa aborda problemas em aberto relacionados à modelagem sequencial, aprendizagem por transferência, robustez adversarial e explicabilidade, testando cada avanço em relação a requisitos de produção, como desempenho de detecção, generalização entre instituições e inferência de baixa latência. A Sardine também foi selecionada para participar do NVIDIA Innovation Lab, um programa de aceleração de 60 dias destinado a membros selecionados do NVIDIA Inception. Por meio do programa, a Sardine tem acesso à computação acelerada da NVIDIA, a software de IA e a conhecimento técnico especializado para otimizar e validar as cargas de trabalho de seus modelos fundacionais.
O que pesquisaremos a seguir
O primeiro modelo nos forneceu evidências de que representações baseadas em sequências podem melhorar a detecção de fraudes na emissão. As próximas questões dizem respeito a até onde essa abordagem pode chegar.
Generalização entre emissores
Como as representações aprendidas entre os emissores participantes podem melhorar a detecção de fraudes em uma instituição que o modelo nunca viu?
Em testes iniciais com um emissor totalmente excluído do treinamento, os embeddings aumentaram a AUC-PR de aproximadamente 0,05–0,07 para 0,14–0,21, em comparação com uma sólida linha de base baseada em atributos elaborados manualmente.
Modelagem de eventos com múltiplos fluxos
O comportamento financeiro vai muito além das transações com cartão.
A inteligência de dispositivos, a biometria comportamental, o onboarding e o KYC, os inícios de sessão, as transações com cartão, as operações ACH e as transferências, bem como as contestações, captam diferentes partes do mesmo histórico do cliente.
Estamos pesquisando como esses eventos podem ser modelados como uma única sequência do cliente, incluindo a tokenização compartilhada, as relações entre os eventos e o valor de sinais esparsos em comparação com a intensa atividade transacional.
Leis de escala para modelos financeiros
Como o desempenho muda à medida que aumentam o número de emissores, a extensão dos históricos dos clientes e o tamanho do modelo?
Estamos pesquisando se existem leis de escala consistentes para modelos de eventos financeiros.
Correspondência de nomes
As representações aprendidas podem melhorar a forma como determinamos se dois registos pertencem à mesma pessoa?
Estamos investigando se dados como nome, endereço, data de nascimento e endereços anteriores podem melhorar a correspondência entre duas identidades.
Abordagens baseadas em grafos
A atividade financeira é simultaneamente sequencial e relacional. Os pagamentos conectam pessoas, empresas, contas, dispositivos e contrapartes em redes.
Estamos explorando como os transformadores de grafos podem produzir embeddings que representem as relações entre contrapartes em pagamentos, inclusive se esses embeddings conseguem identificar tipologias de lavagem de dinheiro, como pagamentos encadeados por meio de várias contrapartes para evitar a detecção.
Inferência com baixa latência
Um modelo pode apresentar um bom desempenho offline e, ainda assim, ser inutilizável para a tomada de decisões em tempo real.
Estamos pesquisando abordagens para disponibilizar modelos de detecção de fraudes com cartões com mais de 100 milhões de parâmetros e latência muito baixa, utilizando todo o histórico de transações de cada cliente. Isso pode exigir suporte a janelas de contexto com mais de um milhão de tokens.
A questão principal é: quanto contexto você pode usar sem tornar a decisão mais lenta?
Aprendizado a frio
Quanto histórico é necessário para que os embeddings aprendidos superem os atributos tradicionais baseados em agregação?
Aplicações além da fraude
As representações aprendidas a partir da atividade financeira podem ser transferidas para outras tarefas preditivas?
As possíveis aplicações incluem:
- Risco de crédito
- Previsão de rotatividade de clientes
- Previsão de gastos
- Categorização de comerciantes
Estas são áreas de investigação, não alegações sobre o produto.
US$ 375.000 para pesquisa independente
Também queremos que pesquisadores de fora da Sardine trabalhem nessas questões.
A Sardine AI Labs está oferecendo até cinco bolsas de pesquisa de até US$ 75.000 cada, totalizando até US$ 375.000, a pesquisadores independentes que trabalham em problemas relevantes para a detecção de crimes financeiros.
As áreas de pesquisa incluem:
- Generalização entre emissores
- Modelagem de eventos de múltiplos fluxos
- Leis de escala
- Correspondência de identidade
- Detecção de padrões de lavagem de dinheiro
- Inferência em tempo real na faixa das poucas centenas de milissegundos
- Aprendizado a partir do zero
- Outras aplicações além da fraude
Os beneficiários da bolsa terão acesso a um conjunto de dados anonimizado e delimitado à sua área de investigação. As candidaturas serão avaliadas pela equipa de ciência de dados da Sardine com base na abordagem proposta e no percurso do investigador.
As inscrições estão abertas até 30 de novembro de 2026. Os candidatos pré-selecionados serão notificados em dezembro, e os beneficiários finais serão anunciados em 10 de janeiro de 2027.
Candidate-se a uma bolsa de investigação →
Acompanhe a investigação
Planejamos publicar os métodos, resultados e limitações deste trabalho, e não apenas os números de destaque. Nosso primeiro relatório técnico apresenta uma análise mais aprofundada do modelo fundacional de emissão, incluindo a preparação dos dados, a tokenização, a arquitetura, os experimentos, os resultados e as questões em aberto.
Continuaremos publicando à medida que testarmos estas abordagens em mais instituições, sinais e problemas relacionados com crimes financeiros.
Porque a questão interessante não é se a IA consegue gerar mais uma pontuação de fraude.
É o quanto mais um modelo consegue compreender quando aprende o comportamento por trás dessa pontuação.
Perguntas frequentes
O que é o Sardine AI Lab?
O Sardine AI Labs é o grupo de pesquisa aplicada da Sardine dedicado ao avanço da IA na detecção de crimes financeiros. Pesquisamos como os modelos podem aprender com comportamentos financeiros, generalizar entre diferentes instituições e combinar de forma mais eficaz sinais de transações, dispositivos, identidade e comportamento.
Quais dados são usados na pesquisa de modelos fundacionais?
A pesquisa inicial utiliza históricos de emissão de cartões de 13 emissores em programas voltados para consumidores, PMEs, cartões de criptomoedas e neobancos, abrangendo o período de janeiro de 2024 a julho de 2026.
O histórico de cada titular de cartão é representado como uma sequência de aproximadamente 2.300 transações, com 14 campos por transação, abrangendo comerciante, MCC, valor, data e hora, localização geográfica, modo de entrada, contexto de presença, informações do terminal e saldo do cartão.
Qual é a diferença entre o Sardine AI Labs e o trabalho que a Sardine já desenvolve com modelos fundacionais?
O trabalho com o modelo de base é a própria pesquisa.
O Sardine AI Labs é onde publicamos essa pesquisa, tornamos pública a agenda de pesquisa e disponibilizamos partes do trabalho a pesquisadores externos por meio do nosso programa de bolsas.
Quem pode candidatar-se a uma bolsa de investigação?
Investigadores independentes e equipas académicas que trabalhem em problemas relevantes para a deteção de crimes financeiros podem candidatar-se.
As candidaturas são avaliadas com base na abordagem de investigação proposta e no historial do investigador.
Onde posso ler a pesquisa?
A Sardine AI Labs publicará relatórios técnicos e textos explicativos mais curtos sobre as pesquisas, abordando os métodos, os resultados e as limitações do trabalho.
O primeiro relatório técnico aprofunda o modelo fundacional de emissão, incluindo a preparação dos dados, a tokenização, a arquitetura, os resultados e as questões em aberto.