

AIは金融行動の構造を十分に学習し、明示的に検出するよう訓練されていない攻撃まで見つけ出せるのでしょうか?
この問いを追究するために設立されたのが、応用研究グループである「Sardine AI Labs」です。私たちは、AIが金融行動の言語をどのように学習できるかを研究しています。具体的には、モデルが一連の金融活動から学習し、その知見を異なる金融機関にも応用し、明示的に学習していない攻撃を予測するとともに、リスク管理チームがより迅速かつ的確な意思決定を行えるよう支援する方法を探っています。
しかし、モデル性能の向上は課題の一部にすぎません。私たちは、検知性能、金融機関をまたいだ汎化性能、低レイテンシーでの推論など、実運用のリスク管理システムに求められる要件に照らして、各技術的進展を検証しています。モデルの精度だけでなく、レイテンシー、ガバナンス、説明可能性、人による監督の要件も併せて評価します。Sardine AI Labsの立ち上げにあたり、イシュイングリスク向けの初の基盤モデルから得られた知見、今後取り組む研究分野、そして同じ課題に取り組む独立研究者を対象とした最大37万5,000ドルの研究助成金を発表します。
金融犯罪における最難関の課題を解決する
基盤モデルの次なる進歩は、独自の実世界データにアクセスできる、特定分野に特化したAIラボから生まれる可能性が高いでしょう。詐欺や金融犯罪の防止はその好例です。優秀な学術研究者であっても、この分野を前進させるために必要な大規模データセットを利用できないことが少なくありません。
金融犯罪対策には多額のコストがかかり、金融機関はその多くをACH手数料、電信送金手数料、カードのインターチェンジフィーという形で利用者に転嫁しています。この分野では、特に難しい問題の一部がいまだ解決されていません。たとえば、制裁対象者リストに載っている人物とよく似た名前の消費者は、本人確認において2つの名前が同一人物を指すかどうかの照合が今なお非常に難しいため、顧客受け入れ手続きの待機列に何週間も留め置かれることがあります。何十億件もの取引の中からマネーロンダリング、テロ資金供与、麻薬取引を見つけ出すことも同様に難しく、そのため決済の滞留や数百万ドル規模の罰金が今も珍しくありません。
金融行動の言語を学ぶ
言語と同様に、決済活動やアクセス行動にも固有のパターンがあります。取引履歴、デバイス、IPアドレスから形成される行動プロファイルを基盤モデルで分析することで、異常を特定し、不正の可能性を検知できます。
多くのリスクモデルは、個々の取引を起点に、それが不審に見えるかどうかを判断します。私たちはさらに、その取引を取り巻く履歴もモデルが学習した場合に何が起こるのかにも注目しています。単独ではごく普通に見える支払いでも、その前に何が起きていたのか、どのデバイスから実行されたのか、その顧客が普段どのように行動しているのか、そして一連の長期的な行動の中でその支払いがどこに位置するのかを把握することで、その意味は変わります。
これは、Sardine AI Labsにおける私たちの取り組みの多くを支える前提です。金融活動を、個々に切り離された事象の集まりではなく、一連の流れとして捉える。
私たちの研究は、Sardineが有する以下のネットワークを活用しています:
- 65億台以上のデバイスをプロファイリング
- 4億4,100万件の消費者ID
- 340万社の企業を審査
- 66億件の取引を分析
- 1.8兆ドル相当の取引を保護
このネットワークは、セッション、取引、顧客プロファイルを横断して、金融行動が時間とともにどのように変化するかを研究するための大規模な基盤となっています。また、別の目的で構築されたモデルをリスク用途に転用するのではなく、リスクに特化したモデルを構築できる立場にあるのも、このネットワークがあるからです。
発行リスク向け初の基盤モデルから得られた知見
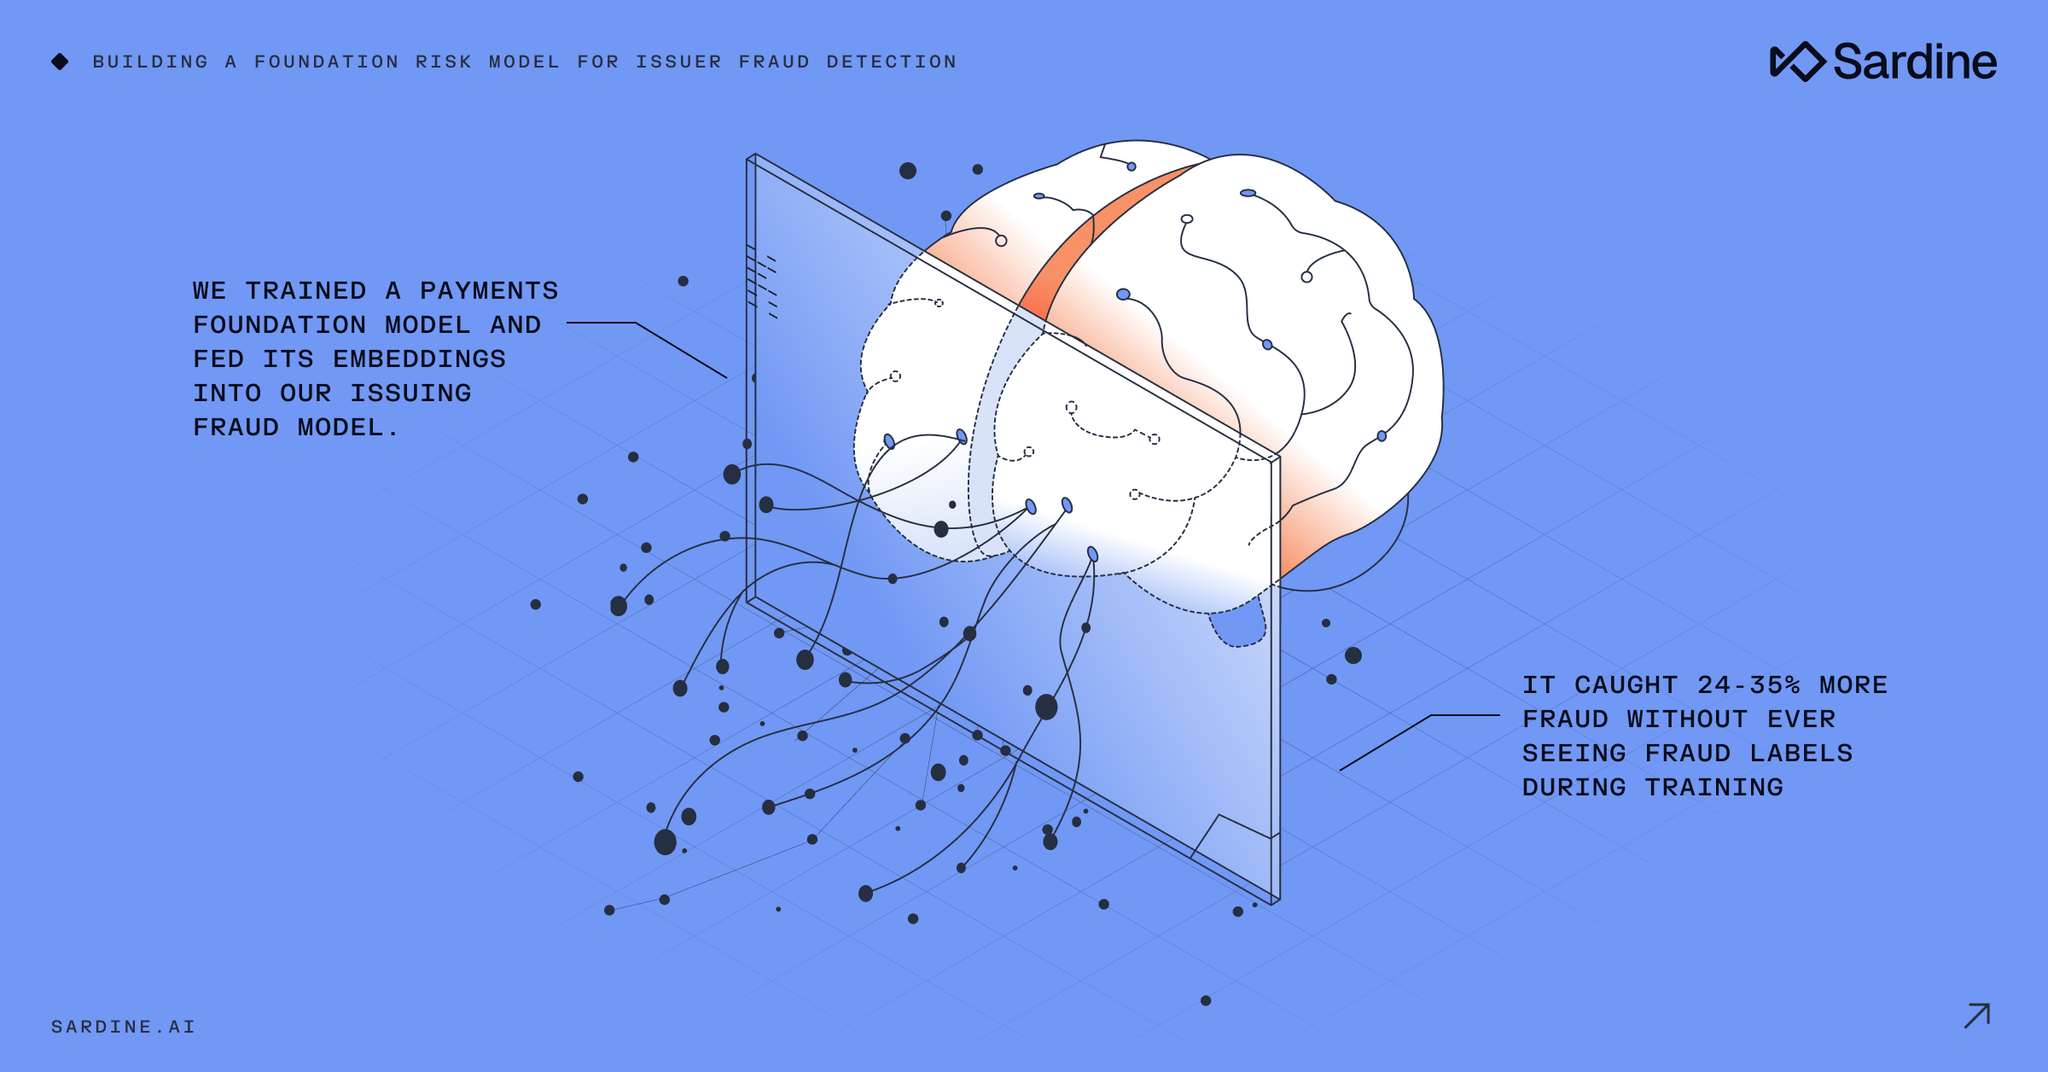
私たちが初めて開発した決済基盤モデルでは、あるシンプルなアイデアを検証しました。
モデルは、不正利用のラベルを一度も見る前に、カード会員の行動を有用に表現する方法を学習できるのでしょうか?
ラベル付けされた不正利用の結果だけで学習するのではなく、モデルはまずラベルのない取引履歴から学習します。そこで獲得した表現を、すでに本番稼働しているカード発行会社の不正検知モデルに特徴量として入力します。このアプローチは「まず学習し、次に分類する」というものです:
- 加盟店、金額、時刻、地域、チャネル、端末の情報をトークン化します。
- 10か月分を超えるラベルなしの取引履歴で事前学習する。
- 各カード保有者の履歴を8層のTransformerで表現します。
- 学習した特徴量を既存の不正検知モデルと組み合わせます。
このモデルは、13社のカード発行会社から得た過去2年間の約10億件の取引データを用いて学習されており、カード会員の行動を静的な特徴量の集合に単純化するのではなく、取引履歴全体から学習しています。
初期結果:
- 不正検知精度(AUC-PR)が68%向上(トレーニングデータセットから除外した消費者向けカード発行会社において)
- 不正検知精度(AUC-PR)が41%向上(トレーニングデータセットから除外した法人カード発行会社の場合)
- 不正検知件数が35%増加(同じ取引件数で)
ホールドアウトしたカード発行会社に対する結果が重要なのは、不正検知における最も難しい課題の一つを検証できるからです。つまり、モデルは他で学習した内容を、これまで一度も見たことのない金融機関にも応用できるのでしょうか?
新規カード発行会社は、特有のコールドスタート問題に直面します。サービス開始時には、不正を確実に検知するために必要な学習データが不足している一方で、詐欺グループは新たに提供された金融商品を悪用しようとします。学習対象から完全に除外した発行会社を用いたテストでは、消費者向け、法人向け、グローバルな越境取引を扱うカード発行会社のいずれにおいても、モデルの性能向上が確認されました。特に重要な発見の一つは、基盤モデルが「しなかった」ことです。つまり、既存の不正検知モデルを置き換えたわけではありません。データサイエンス責任者のNiranjan Shettyは、次のように述べています。「最も重要な成果は、ユーザーの取引行動を表形式の特徴量に圧縮するよりも、基盤モデルで直接捉えることで、不正を正確に特定する能力が大幅に向上したことです。こうしたパターンは、単一のプログラムに過度に適合するのではなく、金融機関をまたいで転用できます。今後の課題は、このインテリジェンスを、本番環境でのリスク判断を支えられるほど高速で、説明可能かつ信頼性の高いものにすることです。」
学習された埋め込み表現は、単独では性能が劣っていました。既存のモデルと組み合わせることで、最も高い性能を発揮しました。
これは、不正検知における基盤モデルのより有用な役割を示しています。つまり、リスク管理の仕組み全体を置き換えるのではなく、既存のリスクモデルに顧客行動をより豊かに表現する情報を与えることです。
モデルを支えるデータ
初期調査では、消費者向け、中小企業向け、暗号資産カード、ネオバンクの各プログラムにおける13社のカード発行会社のカード発行履歴を使用しています。
対象期間は2024年1月から2026年7月までで、発行会社ごとに最大31か月分のデータを網羅しています。
各カード保有者の全履歴は、約2,300件の取引からなる1つのシーケンスにまとめられます。各取引には、加盟店、MCC、金額、時刻、地域、入力方式、カード提示状況、端末情報、カード残高など、14の固定フィールドが含まれます。目的は、モデルに金融データを生成させることではありません。学習するのは、何が起きたのか、それがいつ起きたのか、そして次に何が起こりやすいのかを捉える行動表現です。
研究段階の性能から本番環境での性能へ
オフラインで高い性能を発揮するモデルが、実運用のリスクシステムでも必ずしも有用とは限りません。
Sardine AI Labsは、AIの進歩を金融犯罪に対する測定可能な防御へとつなげることに注力しています。私たちにとって、それはベンチマーク上の精度だけでなく、実環境でのレイテンシ、ガバナンス、説明可能性といった本番環境レベルの要件を当初から重視することを意味します。私たちの研究では、系列モデリング、転移学習、敵対的攻撃に対する堅牢性、説明可能性に関する未解決の課題に取り組むと同時に、検知性能、金融機関をまたいだ汎化性能、低レイテンシ推論などの本番環境要件に照らして、それぞれの進歩を検証しています。また、Sardineは、NVIDIA Inceptionの選抜メンバーを対象とする60日間のアクセラレータープログラム「NVIDIA Innovation Lab」への参加企業にも選ばれました。このプログラムを通じて、SardineはNVIDIAのアクセラレーテッドコンピューティング、AIソフトウェア、技術的専門知識を活用し、基盤モデルのワークロードを最適化・検証できます。
次に取り組む研究テーマ
最初のモデルにより、シーケンスベースの表現がカード発行における不正検知の精度向上に役立つことが示されました。次に検証すべきは、このアプローチがどこまで通用するかです。
発行会社間での汎化
参加する複数のカード発行会社から学習した表現は、モデルがこれまで見たことのない金融機関における不正検知をどのように向上させられるでしょうか?
完全にホールドアウトした発行会社を対象とする初期テストでは、埋め込み表現により、強力な手作業特徴量ベースラインと比較して、AUC-PRが約0.05~0.07から0.14~0.21に向上しました。
マルチストリームイベントモデリング
金融行動は、カード取引だけにとどまりません。
デバイスインテリジェンス、行動バイオメトリクス、オンボーディングとKYC、ログイン、カード取引、ACHおよび送金、異議申し立ては、いずれも同じ顧客履歴の異なる側面を捉えています。
当社では、共有トークン化、イベント間の関係性、密度の高い取引アクティビティと比較した疎なシグナルの価値などを含め、これらのイベントを単一の顧客シーケンスとしてモデル化する方法を研究しています。
金融モデルのスケーリング則
発行会社数、顧客履歴の長さ、モデルサイズが増加するにつれて、パフォーマンスはどのように変化するのでしょうか?
金融イベントモデルに一貫したスケーリング則が存在するかどうかを研究しています。
名前の照合
学習済みの表現を活用することで、2つのレコードが同一人物のものかどうかをより正確に判定できるでしょうか?
氏名、住所、生年月日、過去の住所といった情報を活用することで、2つの個人情報が同一人物のものかどうかをより正確に照合できるかを検証しています。
グラフベースのアプローチ
金融活動には、時系列的な側面と関係性の側面があります。決済は、人、企業、口座、デバイス、取引相手を結び付け、ネットワークを形成します。
私たちは、グラフ・トランスフォーマーを用いて、決済における取引相手との関係性を表現する埋め込みを生成する方法を研究しています。また、検知を逃れるために複数の取引相手を介して連鎖的に行われる決済など、マネーロンダリングの類型をこうした埋め込みによって特定できるかどうかも検証しています。
低レイテンシでの推論
モデルはオフラインでは高い性能を発揮しても、リアルタイムの意思決定には使えない場合があります。
各顧客の全取引履歴を活用しながら、1億を超えるパラメータを持つカード不正検知モデルを極めて低いレイテンシーで提供する手法を研究しています。そのためには、100万トークンを超えるコンテキストウィンドウへの対応が必要になる可能性があります。
重要なのは、意思決定を遅らせることなく、どれだけ多くのコンテキストを活用できるかという点です。
コールドスタート学習
学習済みの埋め込み表現が従来の集約ベースの特徴量を上回るには、どの程度の履歴が必要ですか?
不正検知以外の応用
金融活動から学習した表現は、他の予測タスクにも転用できるのでしょうか?
想定される応用例:
- 信用リスク
- 解約予測
- 支出予測
- 加盟店のカテゴリ分類
これらは研究分野であり、製品に関する主張ではありません。
独立研究に375,000ドル
また、Sardine以外の研究者にも、これらの課題に取り組んでもらいたいと考えています。
Sardine AI Labsは、1件あたり最大75,000ドルの研究助成金を最大5件、総額最大375,000ドルまで、金融犯罪の検知に関連する課題に取り組む独立系研究者に提供します。
研究分野には以下が含まれます:
- 発行体をまたいだ汎化
- マルチストリームイベントモデリング
- スケーリング則
- 同一人物の照合
- マネーロンダリングのパターン検知
- 数百ミリ秒前半でのリアルタイム推論
- コールドスタート学習
- 不正検知以外の応用
助成金の採択者には、各自の研究分野に応じた匿名化データセットへのアクセス権が付与されます。申請内容は、提案されたアプローチと研究者の実績に基づき、Sardineのデータサイエンスチームが審査します。
応募受付期間は2026年11月30日までです。最終候補者には12月中に通知し、助成対象者は2027年1月10日に発表します。
研究助成金に応募する →
研究の進展を追う
私たちは、目を引く数字だけでなく、この取り組みの背景にある手法、結果、限界についても公開する予定です。最初の技術レポートでは、データの準備、トークン化、アーキテクチャ、実験、結果、未解決の課題など、基盤モデルのリリースについてさらに詳しく解説します。
今後、より多くの金融機関、シグナル、金融犯罪の課題を対象にこれらのアプローチを検証し、その成果を引き続き公開していきます。
なぜなら、重要なのはAIが新たな不正スコアを算出できるかどうかではないからです。
重要なのは、そのスコアの背後にある行動を学習することで、モデルがどれだけ深く理解できるようになるかです。
よくある質問
Sardine AI Labとは何ですか?
Sardine AI Labsは、金融犯罪検知のためのAI技術の進歩に取り組むSardineの応用研究グループです。金融行動からモデルが学習する方法、金融機関をまたいで汎化する方法、そして取引・デバイス・本人確認・行動に関するシグナルをより効果的に組み合わせる方法を研究しています。
基盤モデルの研究では、どのようなデータを使用していますか?
初期調査では、消費者向け、中小企業向け、暗号資産カード、ネオバンクの各プログラムにわたる13社の発行会社のカード発行履歴を使用しており、対象期間は2024年1月から2026年7月までです。
各カード会員の利用履歴は約2,300件の取引からなる時系列データとして表現され、各取引には加盟店、MCC、金額、取引時刻、地域、入力方式、カード提示状況、端末情報、カード残高など14項目が含まれます。
Sardine AI Labsは、Sardineがこれまで取り組んできた基盤モデル開発とどのように異なりますか?
基盤モデルの開発そのものが研究です。
Sardine AI Labsでは、その研究成果を公開し、研究課題を明らかにするとともに、助成プログラムを通じて研究の一部を外部の研究者に開放しています。
研究助成金には誰が応募できますか?
金融犯罪の検知に関連する課題に取り組む独立系研究者および学術研究チームが応募できます。
応募内容は、提案された研究アプローチと研究者の実績に基づいて審査されます。
研究内容はどこで読めますか?
Sardine AI Labsは、本研究の手法、成果、限界について解説する技術レポートや、より簡潔な研究解説記事を公開します。
最初の技術レポートでは、データの前処理、トークン化、アーキテクチャ、結果、未解決の課題など、カード発行向け基盤モデルについてさらに詳しく解説しています。