

¿Puede la IA aprender la estructura del comportamiento financiero lo suficientemente bien como para detectar ataques para los que nunca fue entrenada explícitamente?
Esa es la pregunta que impulsa a Sardine AI Labs, nuestro grupo de investigación aplicada, que estudia cómo la IA puede aprender el lenguaje del comportamiento financiero. Estamos explorando cómo los modelos pueden aprender de secuencias de actividad financiera, aplicar lo aprendido en distintas instituciones, anticipar ataques para los que no fueron entrenados explícitamente y ayudar a los equipos de riesgo a tomar decisiones mejores y más rápidas.
Pero mejorar el rendimiento de los modelos es solo una parte del problema. Evaluamos cada avance frente a las exigencias de los sistemas de riesgo en producción, incluido el rendimiento de detección, la generalización entre instituciones y la inferencia de baja latencia. La precisión de los modelos se mide junto con la latencia, la gobernanza, la explicabilidad y los requisitos de supervisión humana. Presentamos Sardine AI Labs con los hallazgos de nuestro primer modelo fundacional para el riesgo de emisión, las áreas de investigación que abordaremos a continuación y hasta 375.000 dólares en subvenciones para investigadores independientes que trabajen en los mismos problemas.
Resolviendo los problemas más difíciles de la delincuencia financiera
Es probable que la próxima ola de avances en los modelos fundacionales provenga de laboratorios de IA especializados en ámbitos concretos y con acceso a datos propios del mundo real. La prevención del fraude y los delitos financieros es un buen ejemplo: incluso los investigadores académicos más destacados suelen carecer de los conjuntos de datos a gran escala necesarios para impulsar el avance en este campo.
La prevención de los delitos financieros también es costosa, y las instituciones financieras trasladan gran parte de ese coste mediante comisiones por transferencias ACH, transferencias bancarias y tasas de intercambio de tarjetas. Algunos de los problemas más difíciles en este ámbito siguen sin resolverse. Un consumidor cuyo nombre se parezca mucho al de una persona incluida en una lista de sanciones puede pasar semanas en una cola de incorporación, porque determinar si dos nombres corresponden a la misma persona sigue siendo realmente difícil. Detectar el blanqueo de capitales, la financiación del terrorismo o el narcotráfico entre miles de millones de transacciones es igual de complicado, por lo que los pagos bloqueados y las multas multimillonarias siguen siendo habituales.
Aprender el lenguaje del comportamiento financiero
Al igual que el lenguaje, la actividad de pago y el comportamiento de acceso presentan patrones diferenciados. Los historiales de transacciones, los dispositivos y las direcciones IP conforman perfiles de comportamiento que los modelos fundacionales pueden analizar para identificar anomalías y detectar posibles fraudes.
La mayoría de los modelos de riesgo parten de una transacción individual y evalúan si parece sospechosa. También nos interesa saber qué ocurre cuando el modelo aprende del historial que rodea a esa transacción. Un pago puede parecer normal de forma aislada, pero su significado cambia cuando se sabe qué ocurrió antes, desde qué dispositivo se inició, cómo suele comportarse el cliente y qué lugar ocupa ese pago dentro de una secuencia de actividad más amplia.
Esa es la premisa en la que se basa gran parte de nuestro trabajo en Sardine AI Labs: tratar la actividad financiera como una secuencia, no como un conjunto de eventos aislados.
Nuestra investigación se basa en la red de Sardine, que incluye:
- Más de 6.500 millones de dispositivos analizados
- 441 millones de identidades de consumidores
- 3,4 M de empresas verificadas
- 6.600 millones de transacciones analizadas
- 1,8 billones de dólares en transacciones protegidas
Esa red nos proporciona una amplia base para estudiar cómo evoluciona el comportamiento financiero a lo largo del tiempo en distintas sesiones, transacciones y perfiles de clientes. También es lo que nos permite desarrollar un modelo diseñado específicamente para la gestión del riesgo, en lugar de adaptar uno creado con otro propósito.
Lo que aprendimos de nuestro primer modelo fundacional para el riesgo de emisión
Nuestro primer modelo fundacional de pagos puso a prueba una idea sencilla:
¿Puede un modelo aprender representaciones útiles del comportamiento de los titulares de tarjetas antes de haber visto siquiera una etiqueta de fraude?
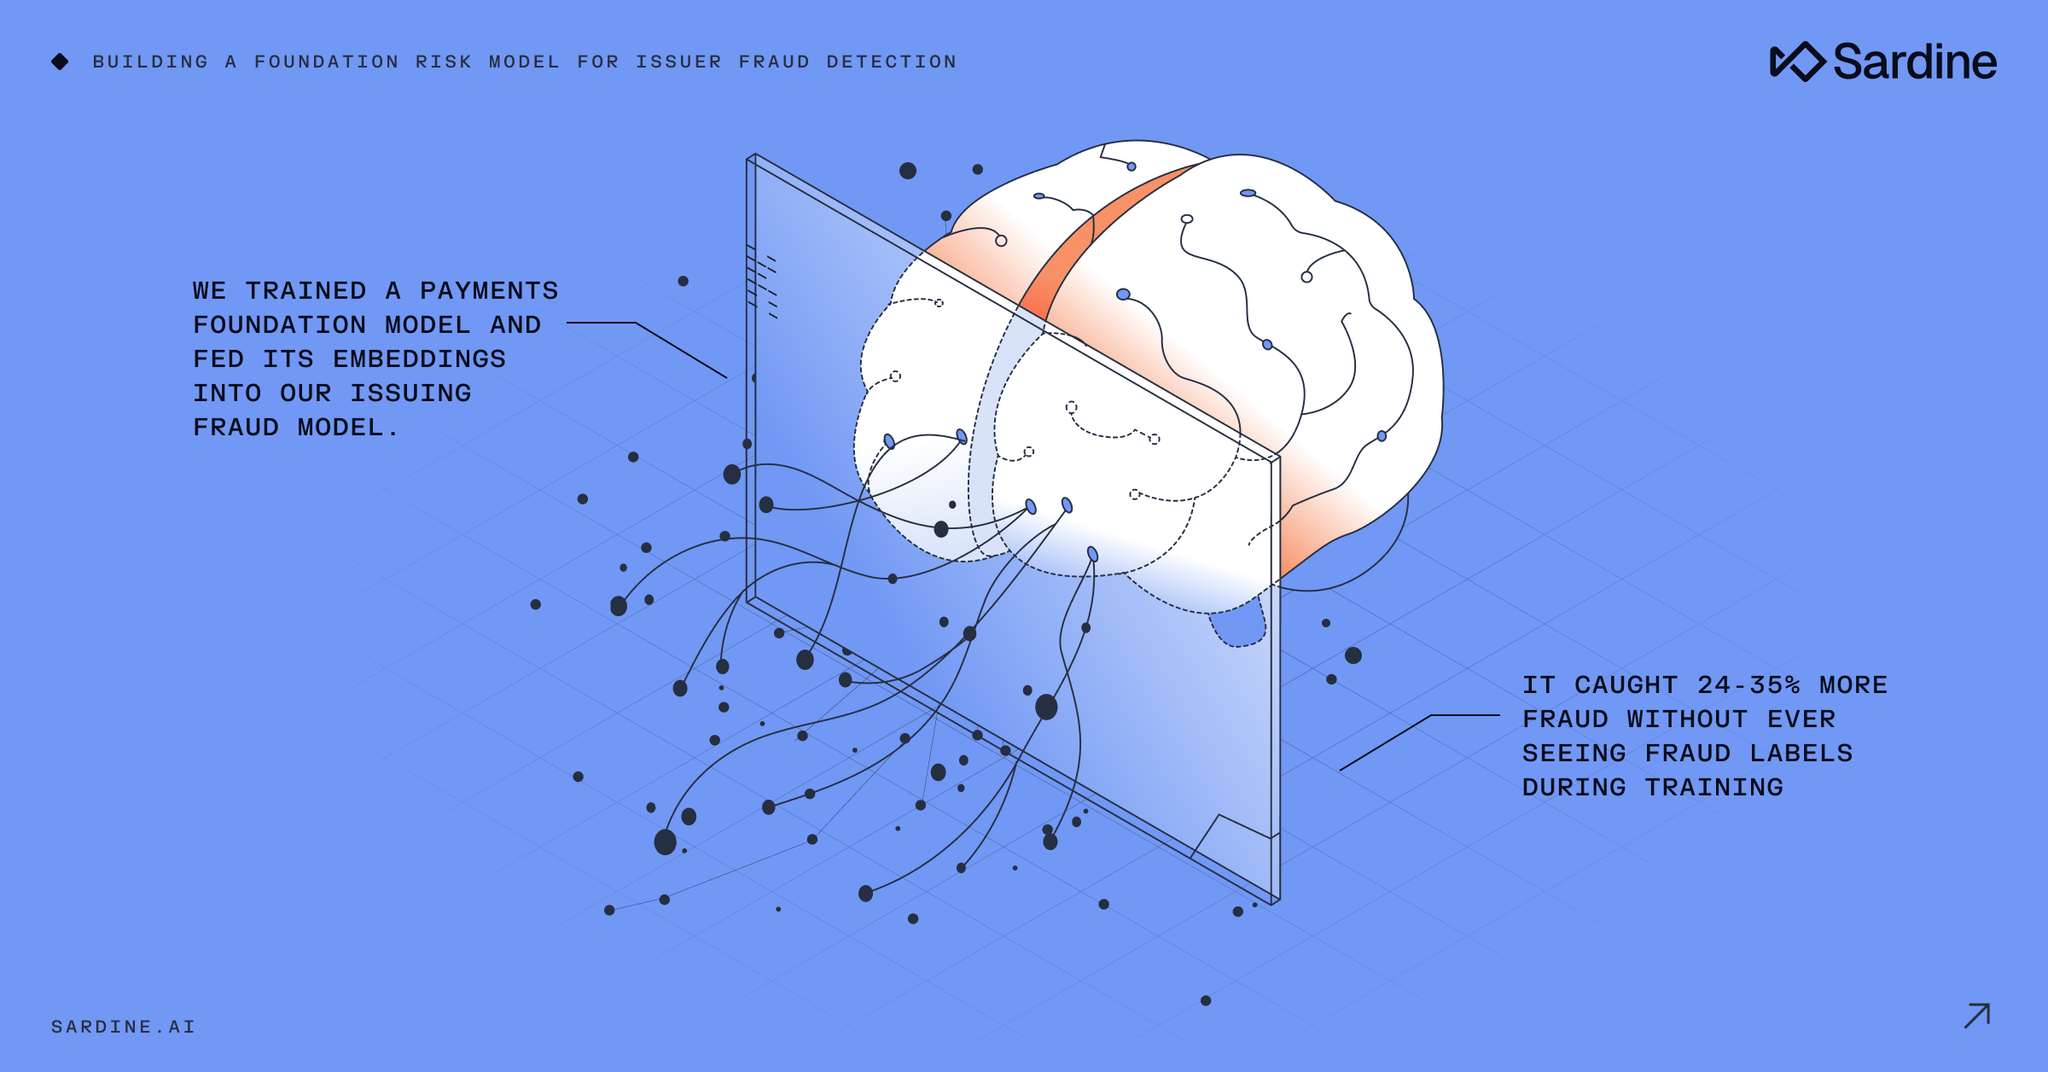
En lugar de entrenarse únicamente con resultados de fraude etiquetados, el modelo aprende primero a partir de historiales de transacciones sin etiquetar. A continuación, las representaciones aprendidas se proporcionan como características al modelo de detección de fraude del emisor que ya está en producción. El enfoque consiste en aprender primero y clasificar después:
- Tokenizar la información del comercio, el importe, la hora, la ubicación geográfica, el canal y el terminal.
- Realizar un preentrenamiento con más de 10 meses de historiales de transacciones sin etiquetar.
- Representar el historial de cada titular de tarjeta mediante un transformador de ocho capas.
- Combine esas características aprendidas con el modelo de fraude existente.
El modelo se entrenó con aproximadamente mil millones de transacciones realizadas durante los últimos dos años por clientes de 13 emisores de tarjetas, aprendiendo a partir de los historiales completos de transacciones de los titulares de las tarjetas, en lugar de reducir ese comportamiento a un conjunto estático de características.
Los resultados iniciales:
- Mejora del 68 % en la precisión de la detección de fraude (AUC-PR) para un emisor de tarjetas de consumo excluido del conjunto de datos de entrenamiento
- Mejora del 41 % en la precisión de la detección de fraude (AUC-PR) para un emisor de tarjetas empresariales excluido del conjunto de datos de entrenamiento
- Un 35 % más de fraude detectado con el mismo número de transacciones
Los resultados del emisor excluido son importantes porque ponen a prueba uno de los problemas más difíciles de la detección del fraude: ¿puede un modelo transferir lo que ha aprendido en otros contextos a una institución que nunca antes ha visto?
Los nuevos emisores de tarjetas se enfrentan a un reto particular de arranque en frío. En el momento del lanzamiento, carecen de los datos de entrenamiento necesarios para detectar el fraude de forma fiable, mientras las redes de fraude intentan aprovecharse de los productos financieros recién lanzados. En las pruebas con emisores excluidos por completo del entrenamiento, el modelo mostró mejoras en emisores de tarjetas de consumo, empresariales y transfronterizas a escala mundial. Uno de los hallazgos más importantes fue lo que el modelo fundacional no hizo: no sustituyó al modelo de fraude existente. Nuestro director de Ciencia de Datos, Niranjan Shetty, lo expresó así: «El resultado más importante es que capturar directamente el comportamiento transaccional de un usuario con un modelo fundacional nos permite identificar el fraude con mucha más precisión que comprimir esa información en variables tabulares. Estos patrones se transfieren entre instituciones, en lugar de ajustarse a un único programa. El trabajo que queda por delante consiste en hacer que esa inteligencia sea lo bastante rápida, explicable y fiable como para respaldar las decisiones de riesgo en producción».
Los embeddings aprendidos ofrecieron peores resultados por sí solos. El mejor rendimiento se obtuvo al combinarlos con el modelo existente.
Esto apunta a un papel más útil de los modelos fundacionales en la detección del fraude: ofrecer a los modelos de riesgo existentes una representación más completa del comportamiento de los clientes, en lugar de sustituir toda la infraestructura de gestión de riesgos.
Los datos detrás del modelo
La investigación inicial utiliza historiales de emisión de tarjetas de 13 emisores de programas para consumidores, pymes, tarjetas de criptomonedas y neobancos.
La cobertura abarca desde enero de 2024 hasta julio de 2026, con un máximo de 31 meses por emisor.
El historial completo de cada titular se convierte en una única secuencia que puede alcanzar aproximadamente 2.300 transacciones. Cada transacción contiene 14 campos fijos que abarcan el comercio, el MCC, el importe, el momento, la ubicación geográfica, el modo de entrada, el contexto de presencia, la información del terminal y el saldo de la tarjeta. El objetivo no es enseñar a un modelo a generar datos financieros, sino aprender una representación del comportamiento que refleje qué ocurrió, cuándo ocurrió y qué suele ocurrir después.
Del rendimiento en investigación al rendimiento en producción
Un modelo que funciona bien sin conexión no es necesariamente útil en un sistema de riesgos en producción.
Sardine AI Labs se centra en convertir los avances en IA en una protección cuantificable contra los delitos financieros. Para nosotros, eso implica cumplir desde el principio con requisitos propios de un entorno de producción: latencia en condiciones reales, gobernanza y explicabilidad, no solo precisión en una prueba de referencia. Nuestra investigación aborda problemas abiertos en el modelado secuencial, el aprendizaje por transferencia, la robustez frente a ataques adversarios y la explicabilidad, al tiempo que evalúa cada avance según requisitos de producción, como el rendimiento de detección, la capacidad de generalización entre instituciones y la inferencia de baja latencia. Sardine también ha sido seleccionada para participar en NVIDIA Innovation Lab, un programa de aceleración de 60 días dirigido a miembros seleccionados de NVIDIA Inception. A través del programa, Sardine tiene acceso a computación acelerada de NVIDIA, software de IA y conocimientos técnicos especializados para optimizar y validar las cargas de trabajo de sus modelos fundacionales.
Qué investigaremos a continuación
El primer modelo nos proporcionó pruebas de que las representaciones basadas en secuencias pueden mejorar la detección del fraude en la emisión de tarjetas. Las siguientes preguntas se centran en hasta dónde puede llegar este enfoque.
Generalización entre emisores
¿Cómo pueden las representaciones aprendidas a partir de las entidades emisoras participantes mejorar la detección del fraude en una institución que el modelo nunca ha visto?
En las primeras pruebas realizadas con un emisor totalmente excluido del entrenamiento, los embeddings aumentaron el AUC-PR de aproximadamente 0,05–0,07 a 0,14–0,21 en comparación con una sólida referencia basada en características diseñadas manualmente.
Modelado de eventos de múltiples flujos
El comportamiento financiero va mucho más allá de las transacciones con tarjeta.
La inteligencia de dispositivos, la biometría del comportamiento, la incorporación de clientes y los procesos KYC, los inicios de sesión, las transacciones con tarjeta, las operaciones ACH y las transferencias, así como las disputas, reflejan distintos aspectos del historial de un mismo cliente.
Estamos investigando cómo modelar esos eventos como una única secuencia de actividad del cliente, incluida la tokenización compartida, las relaciones entre eventos y el valor de las señales dispersas en comparación con una actividad transaccional densa.
Leyes de escalado para modelos financieros
¿Cómo cambia el rendimiento a medida que aumentan el número de emisores, la extensión de los historiales de los clientes y el tamaño del modelo?
Estamos investigando si existen leyes de escalado coherentes para los modelos de eventos financieros.
Coincidencia de nombres
¿Pueden las representaciones aprendidas mejorar la forma en que determinamos si dos registros pertenecen a la misma persona?
Estamos explorando si datos como el nombre, la dirección, la fecha de nacimiento y las direcciones anteriores pueden mejorar la forma en que se determina si dos identidades corresponden a la misma persona.
Enfoques basados en grafos
La actividad financiera es tanto secuencial como relacional. Los pagos conectan a personas, empresas, cuentas, dispositivos y contrapartes en redes.
Estamos explorando cómo los transformadores de grafos pueden generar representaciones vectoriales que reflejen las relaciones entre contrapartes en los pagos, y si estas pueden identificar tipologías de blanqueo de capitales, como los pagos encadenados a través de múltiples contrapartes para eludir su detección.
Inferencia con baja latencia
Un modelo puede ofrecer un buen rendimiento sin conexión y, aun así, resultar inutilizable para la toma de decisiones en tiempo real.
Estamos investigando métodos para desplegar modelos de detección de fraude con tarjetas de más de 100 millones de parámetros y una latencia muy baja, utilizando al mismo tiempo el historial completo de transacciones de cada cliente. Esto podría requerir admitir ventanas de contexto de más de un millón de tokens.
La pregunta clave es: ¿cuánto contexto se puede utilizar sin ralentizar la decisión?
Aprendizaje desde cero
¿Cuántos datos históricos se necesitan para que las representaciones aprendidas superen a las características tradicionales basadas en agregaciones?
Aplicaciones más allá del fraude
¿Pueden las representaciones aprendidas a partir de la actividad financiera transferirse a otras tareas predictivas?
Entre las posibles aplicaciones se incluyen:
- Riesgo crediticio
- Predicción de abandono
- Previsión del gasto
- Categorización de comercios
Estas son áreas de investigación, no afirmaciones sobre el producto.
375.000 $ para investigación independiente
También queremos que investigadores ajenos a Sardine trabajen en estas cuestiones.
Sardine AI Labs ofrece hasta cinco becas de investigación de un máximo de 75.000 dólares cada una, por un total de hasta 375.000 dólares, a investigadores independientes que trabajen en problemas relacionados con la detección de delitos financieros.
Las áreas de investigación incluyen:
- Generalización entre emisores
- Modelado de eventos de múltiples flujos
- Leyes de escalamiento
- Correspondencia de identidades
- Detección de patrones de blanqueo de capitales
- Inferencia en tiempo real en apenas unos cientos de milisegundos
- Aprendizaje desde cero
- Otras aplicaciones más allá del fraude
Los beneficiarios de las subvenciones tendrán acceso a un conjunto de datos anonimizados y delimitados según su área de investigación. El equipo de ciencia de datos de Sardine evaluará las solicitudes en función del enfoque propuesto y la trayectoria del investigador.
Las solicitudes estarán abiertas hasta el 30 de noviembre de 2026. Los candidatos preseleccionados recibirán una notificación en diciembre y los beneficiarios definitivos de las subvenciones se anunciarán el 10 de enero de 2027.
Solicita una beca de investigación →
Sigue la investigación
Tenemos previsto publicar los métodos, los resultados y las limitaciones de este trabajo, no solo las cifras más destacadas. Nuestro primer informe técnico profundiza en el modelo fundacional de emisión, incluidos la preparación de los datos, la tokenización, la arquitectura, los experimentos, los resultados y las preguntas pendientes.
Seguiremos publicando nuestros avances a medida que probemos estos enfoques en más instituciones, señales y problemas relacionados con los delitos financieros.
Porque la pregunta interesante no es si la IA puede generar otra puntuación de fraude.
La cuestión es cuánto más puede comprender un modelo cuando aprende el comportamiento que hay detrás de esa puntuación.
Preguntas frecuentes
¿Qué es Sardine AI Lab?
Sardine AI Labs es el grupo de investigación aplicada de Sardine, centrado en impulsar el uso de la IA para detectar delitos financieros. Investigamos cómo los modelos pueden aprender del comportamiento financiero, generalizar sus resultados entre distintas instituciones y combinar de forma más eficaz señales de transacciones, dispositivos, identidad y comportamiento.
¿Qué datos utiliza la investigación de modelos fundacionales?
La investigación inicial utiliza historiales de emisión de tarjetas de 13 emisores en programas para consumidores, pymes, tarjetas de criptomonedas y neobancos, y abarca desde enero de 2024 hasta julio de 2026.
El historial de cada titular de tarjeta se representa como una secuencia de aproximadamente 2300 transacciones, con 14 campos por transacción que abarcan el comercio, el MCC, el importe, la fecha y hora, la ubicación geográfica, el modo de entrada, el contexto de presencia, la información del terminal y el saldo de la tarjeta.
¿En qué se diferencia Sardine AI Labs del trabajo que Sardine ya realiza con modelos fundacionales?
El trabajo en el modelo fundacional constituye la investigación en sí misma.
Sardine AI Labs es el espacio donde publicamos esa investigación, damos visibilidad a la agenda de investigación y abrimos parte del trabajo a investigadores externos a través de nuestro programa de subvenciones.
¿Quién puede solicitar una subvención para investigación?
Pueden presentar su solicitud investigadores independientes y equipos académicos que trabajen en problemas relacionados con la detección de delitos financieros.
Las solicitudes se evalúan en función del enfoque de investigación propuesto y la trayectoria del investigador.
¿Dónde puedo consultar la investigación?
Sardine AI Labs publicará informes técnicos y breves artículos divulgativos sobre los métodos, los resultados y las limitaciones del trabajo.
El primer informe técnico profundiza en el modelo fundacional para la emisión, incluidos la preparación de los datos, la tokenización, la arquitectura, los resultados y las preguntas abiertas.