

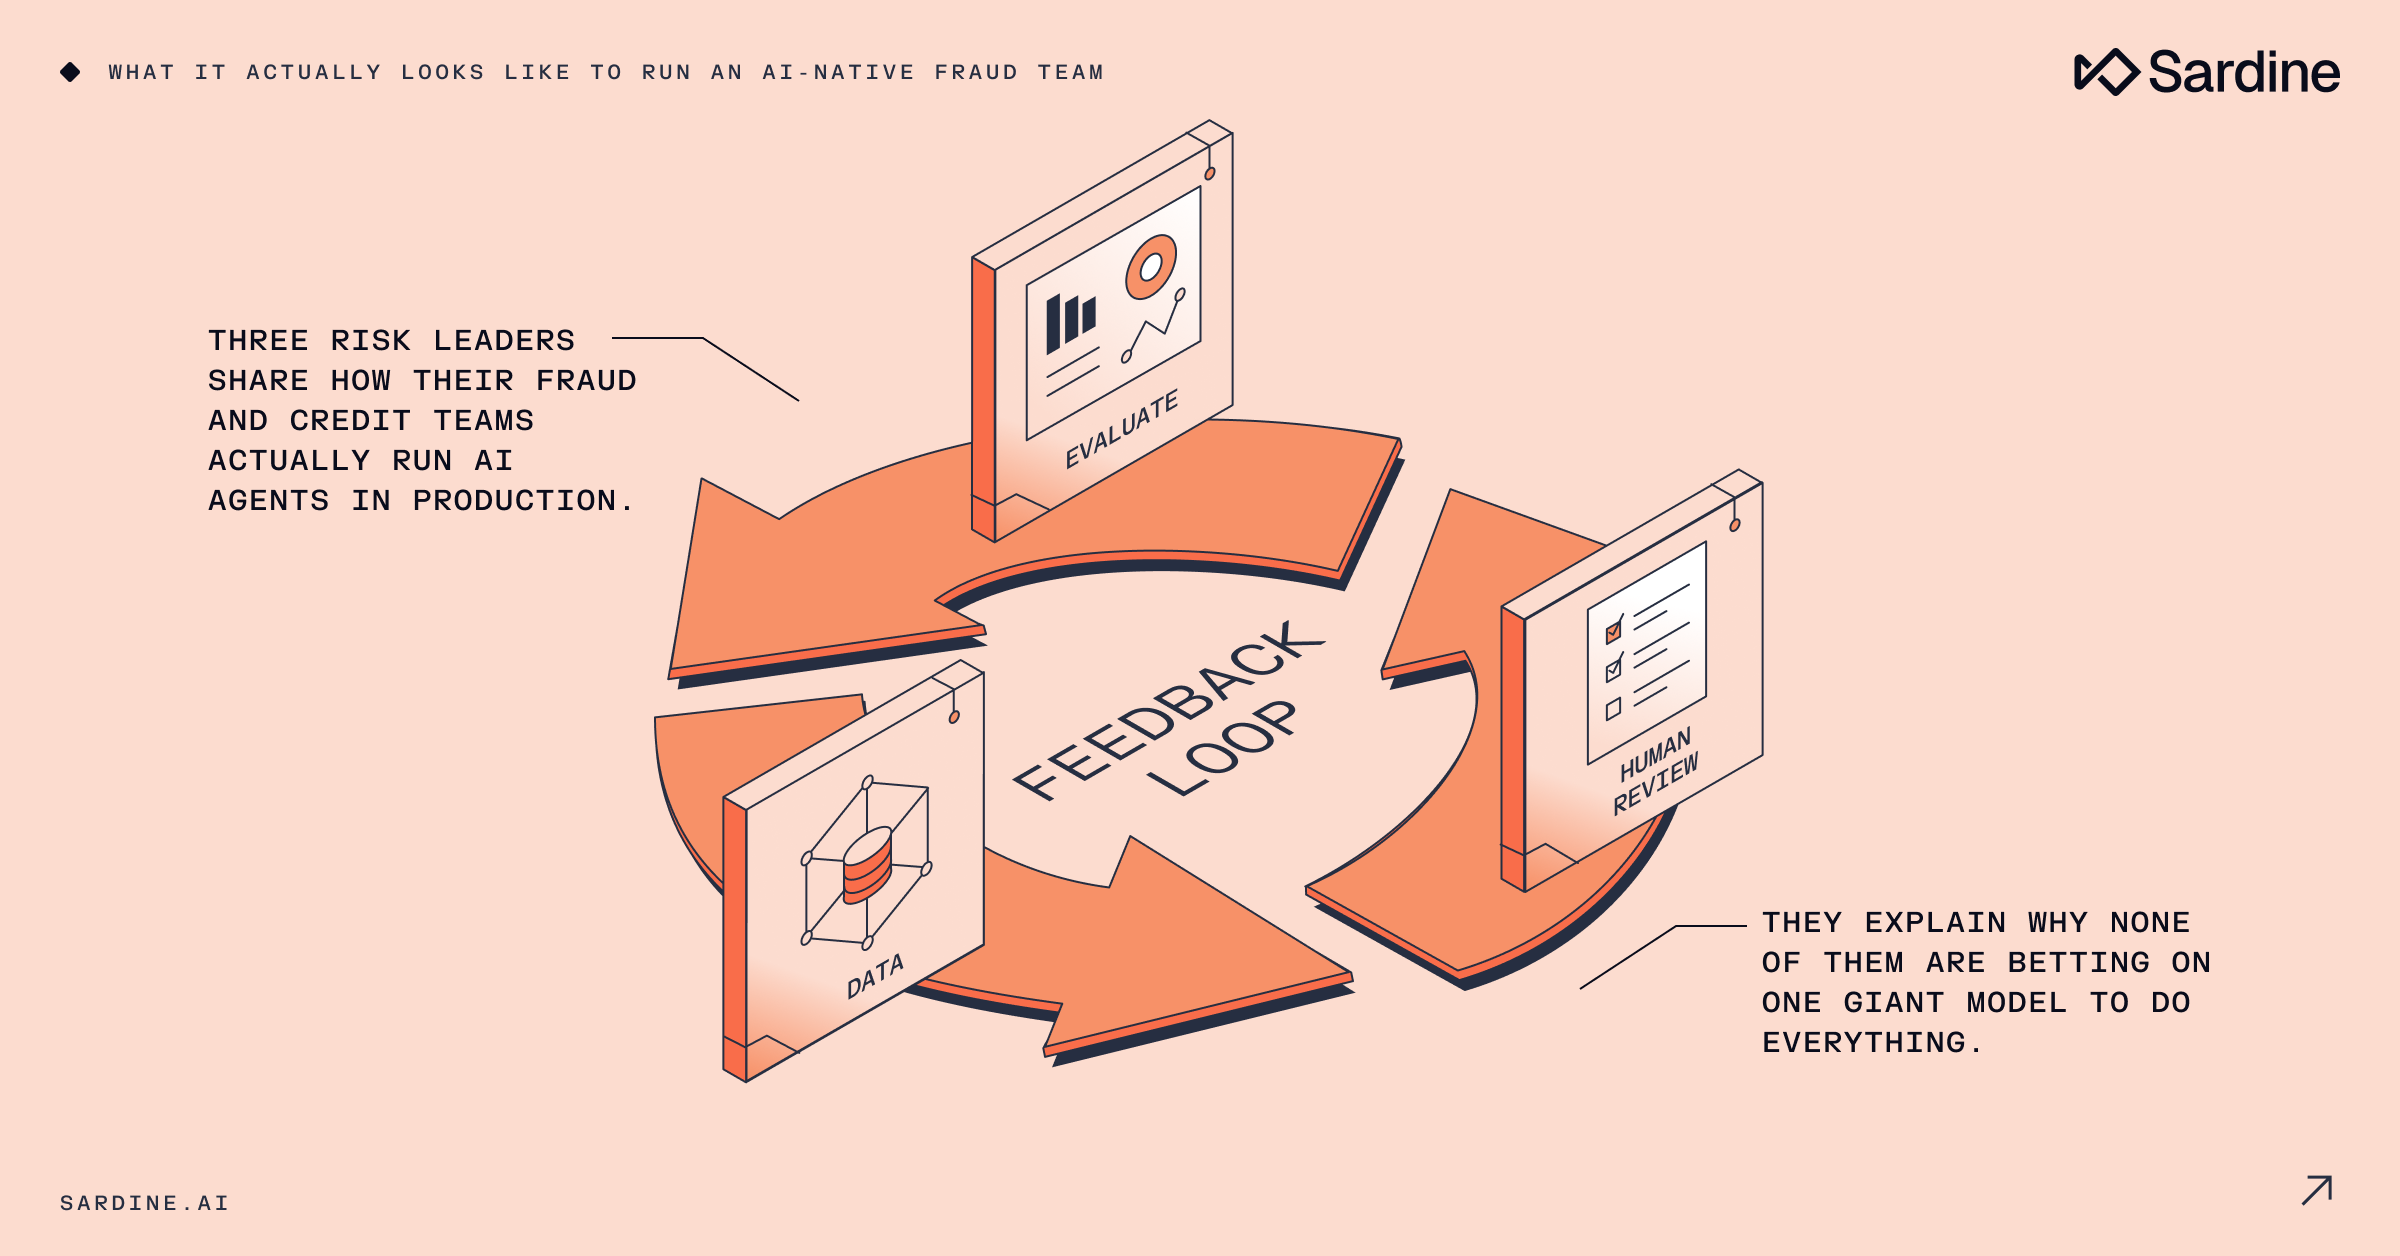
重要なポイント:
- 不正分析担当者の役割は、組織図が変わるよりも先に変化しました。Imprintでは、煩雑なモニタリングやガバナンス業務が自動化され、分析担当者は新たな不正パターンの発見と、その知見をモデルに反映することに、より多くの時間を割けるようになっています。
- AI不正検知エージェントの調整は、一度設定すれば終わりではなく、継続的に行う必要があります。放置すると、エージェントはあらゆるものを不審と判定し、誤検知によって導入効果が損なわれます。
- Intuitの請求書エージェントにおける真の成果は、モデルそのものではなく、不正検知エージェントのフィードバックループだった。大量のシグナルよりも、数を絞った決定力の高いシグナルのほうが優れた成果を上げた。
- 不正ラベルの品質が、エージェントの性能の上限を決めます。正解データの根拠となるレビューの精度が低ければ、エージェントがその水準を超えることはできません。Imprintでは、一般的なレビュアーではなく、訓練を受けた不正検知の専門家を基準にエージェントの性能を評価しています。
- AIネイティブな不正対策チームを運営する企業は、単一の大規模な汎用モデルに賭けてはいません。3社はいずれも、共通の基盤上に構築した特化型エージェントを採用し、各領域のチームが自分たちの業務に関連するエージェントを管理する体制に行き着いています。
SardineConでは、まさにこの課題に日々取り組んでいる3人のリスク管理責任者に登壇してもらいました。Intuitで決済リスクを統括するKarthik、SlopeのLawrence、そしてImprintのLalithaです。決済リスク、中小企業向け融資の審査、消費者信用、詐欺対策と、パネルディスカッションでは幅広いテーマを取り上げました。しかし、繰り返し浮かび上がったのは同じ論点でした。人間向けに構築されたワークフローはエージェントには通用しないこと、モデルのアーキテクチャよりもフィードバックループが重要であること、そして、すべてを支配する単一のモデルを構築しようとしている人は誰もいないということです。
特に印象に残った点をご紹介します。
組織図が変わる前に、不正分析担当者の役割はすでに変わっていた
登壇者全員が、手作業によるモニタリングやSLA達成のための対応に費やす時間が減り、実際に判断力を要する業務により多くの時間を割くようになったという、共通の変化について語りました。
Imprintでは、Lalitha氏によると、煩雑なモニタリングやガバナンス業務の多くが自動化されたことで、リスクアナリストの一日は4か月前とは「まったく異なる」ものになりました。その結果、チームは戦略的な業務や成長に重点を置いた業務に、より多くの時間を割けるようになりました。Intuitでは、Karthik氏が組織レベルで同様の変化が起きていると説明しました。戦略、予測、分析の間にあった従来の境界が曖昧になり、アナリストは部門間で業務を引き継ぐのではなく、成果に対して最初から最後まで責任を持つようになっています。
パネリストの誰も、これを人員削減のための代替策とは捉えていませんでした。Lalithaは、目標は人員数を比例して増やすことなく、チームの処理能力を拡大できるようにすることだと明言しました。理想的には、アナリストは反復的なレビュー作業ではなく、新たな不正パターンの発見に時間を使い、その知見をモデルにフィードバックできるようになります。Karthikもこれに関連して、IntuitのAIエージェントなら、拡大する人間のチームに伴う立ち上がり時間やスキルのばらつきなしに、24時間体制でアカウントレビューを行えると指摘しました。
Slopeの中小企業向け不正審査スタック:トランザクションをトークンとして扱う
ローレンスによる技術解説は、この日最も明快なものでした。従来、Slopeの与信審査では、中小企業の経営者が財務資料を提出し、それを人手で確認していたため、時間と手間がかかっていました。同社初のモデルであるSlope Transformerは、オープンバンキングの生の取引データを直接取り込み、財務指標に変換することで、このプロセスを一変させました。自己申告の書類ではなく、実際の銀行取引から取得したデータを使用するため、改ざんははるかに困難です。
その上にあるレイヤーはさらに興味深いものです。これは、各銀行取引をトークンのように扱い、次に何が起こるかを予測する基盤モデルで、その発想は言語モデルが次の単語を予測する仕組みに似ています。これによりSlopeは、特定の収益や支出の流れが再び発生する可能性や、その時期と金額を予測できます。このモデルは、Slopeが本番環境に移行する前にシャドーモードで運用していた従来のルールベースの手法を上回る性能を示しています。
Lawrence氏は、モデリング業務とコンプライアンス業務を明確に切り分けるよう細心の注意を払っていました。実際の融資判断を行うデフォルト確率モデルには、完全な説明可能性を維持することが求められます。またSlopeは、提携銀行であるLead Bankに代わり、不利益処分通知や規制上の開示が適用法令に準拠するよう徹底しています。
数字で見るImprintのリアルタイム不正検知エージェント
Lalithaは、パネルディスカッションの中でも特に印象的な数字をいくつか紹介しました。Imprintでは、新たな不正パターンを監視し、ルールの厳格化や新機能の開発といった対策を提案するリアルタイムエージェントを運用しています。各エージェントは約6時間稼働し、通常ならアナリストが9日間かけて行う作業を、数百ドル程度のトークンコストで処理します。Lalithaによると、これにより毎月数十万ドル規模の不正被害を防いでいます。
ただし、エージェントを放置すると、あらゆるものを疑わしいと判定しがちです。KarthikとLalithaはともに、各自のチームで共通して見られる傾向としてこの点を挙げました。エージェントには、通常の取引行動が実際にどのようなものかを基準に、継続的な調整を加える必要があります。そうしなければ、誤検知によって得られた効果が損なわれてしまいます。
誰も予想しなかったAI請求書エージェント
Karthik氏は、Intuitのアナリストが、QuickBooksの請求書発行プラットフォームを通過するすべての請求書を1時間ごとにチェックし、前払い、提供済みサービスへの請求、水増しされた金額、あるいは捏造されたように見えるものかどうかを評価するエージェントをどのように構築したかを紹介しました。このエージェントが不正かどうかを直接判断するわけではありません。複数ある判断材料の一つとしてリスク評価を付与し、その結果を後続の、より包括的な不正検知および与信判断エージェントに提供します。
Karthikが繰り返し強調した教訓は、データは多ければ多いほどよいとは限らないということです。Intuitは当初、利用可能なデータをすべてモデルに投入しましたが、その結果、シグナルがノイズに埋もれるという問題が生じました。大量のデータよりも、数を絞った決定力の高いシグナルのほうが優れた成果を上げ、真のプロダクトはモデルそのものではなく、フィードバックループであることが明らかになりました。
2種類のラベルと、「平均的なアナリスト」を上回る高い基準
Intuitのフィードバック手法では、2種類のラベルを使用しています。最終ラベルは、実際に発生した結果、チャージバック、口座閉鎖など、明らかになるまでに時間を要するグラウンドトゥルースに基づきます。一方、合成ラベルは、それまでの間に経験豊富なリスク管理の専門家がサンプル取引へ手作業で注釈を付けることで作成されます。Karthik氏によると、両者を組み合わせることで、モデルにより迅速なシグナルを与えつつ、ガバナンスおよびコンプライアンスの担当者が確認できる監査証跡も残せるとのことです。
Imprintも同様の考え方を採用しており、エージェントの性能を訓練を受けた不正対策の専門家と比較することで、意図的に高い基準を設定しています。Lalithaの洞察によれば、ラベルの品質が性能の上限を決めるため、グラウンドトゥルースの根拠となるレビューの厳密さが不十分であれば、エージェントがその水準を超えることは決してできません。
1つのモデルですべてをこなせるとは誰も考えていない
Karthikは、アーキテクチャについてグループがたどり着いた結論をまとめました。あらゆるユースケースを1つの大規模な汎用モデルで処理しようという業界当初の熱気は、今や冷めつつあります。モデルに過剰なコンテキストを与えると、精度が高まるどころかノイズが増えてしまいます。3社が共通して採用したのは、どのフロンティアモデルでも利用できる共通のエージェント基盤を用意し、その上に与信、不正対策、オペレーションなどの各領域のチームが、自らの専門知識を生かして専用エージェントを構築するという形です。
独自データに関する議論でも、特化を重視する姿勢が改めて浮き彫りになった。3人のパネリストはいずれも、データをフロンティアAI研究所に渡すより、自社で構築したいと述べた。Lawrenceによれば、Slope独自のデータで学習させた小規模モデルなら、フロンティアモデルに匹敵する精度を実現しつつ、レイテンシーとコストの両面で上回ることができる。Lalithaは、Imprintが加盟店と顧客の間に位置しているため、偽造が極めて難しい行動データを得られると指摘した。盗まれた身元情報とは異なり、特定のパートナーとの関係履歴を捏造しても通用しない。Karthikのチームは外部シグナルを購入しているものの、意思決定は社内に留めている。その理由の一つは、過去のベンダーとの関係ではデータが一方的に流出するだけで、Intuit独自のモデルの改善にはまったくつながらなかったことにある。
どこで問題が起き、どうやって発見したのか
失敗した点について率直に問われても、パネリストたちは回答を避けませんでした。Lalithaは、初期の結果は興味深いものの、必ずしも正確ではなかったと振り返り、社内では「Claudeが間違えた」という説明はもはや通用しなくなったと述べました。現在では、各エージェントの動作について責任を負う担当者が明確に定められています。
Karthikのチームは、AIエージェントと人間の担当者の回答一致率をリアルタイムで追跡しており、大幅な乖離が生じた場合は、エージェントの稼働を縮小するか、完全に停止します。Lawrenceは可視性を重視し、Slopeの社内エージェントプラットフォームを公開Slackチャンネル上で運用しています。これにより、エンジニアは誤った回答をオープンな場で発見でき、チーム全体で何が本当に正しいのかについて共通認識を築くことができます。
要点
決済リスク、中小企業向け融資審査、個人向け与信・不正対策のいずれにおいても、共通する運用原則が繰り返し見られました。ワークフローでは、煩雑な作業を自動化して人が判断を要する業務に集中できるようにすること、モデルに実際の意思決定を任せる前に緊密なフィードバックループを構築すること、エージェントには平均的な人間の審査担当者よりも高い基準を課すこと、そして、あらゆることを1つのモデルでこなそうとする誘惑に抗うことが重要です。これは概念実証ではなく、すでに3社の実運用環境で稼働しています。さらに、この手法を実践するチームは、単に遅れずについていっているだけではありません。人員を増やすことなく、アナリストがより多くの案件を処理できるようになっています。
AIネイティブな不正対策チームに関するよくある質問
AIネイティブな不正対策チームは、実際の運用環境ではどのような姿になるのでしょうか?
AIネイティブな不正対策チームでは、1つの汎用モデルにすべてを任せるのではなく、異常検知、ルール作成、請求書のリスク評価、事案調査といった個別のタスクに特化したエージェントを活用します。Intuit、Slope、Imprintの各チームも、同じ考えにたどり着きました。1つのモデルですべてに対応しようとするのではなく、チームは特定の業務に特化した専用エージェントを構築します。そして、各事業部門が自らの業務に関連するエージェントを管理します。
不正検知エージェントのフィードバックループは、時間の経過とともにどのようにモデルの性能を向上させますか?
フィードバックループこそが、システム全体を時間とともに改善させる仕組みです。難しいのは、不正に関する判定が正しかったかどうかを、すぐには把握できないことが多い点です。チャージバックやアカウント閉鎖が発生するまでには、数週間かかる場合があります。そこでIntuitのチームは、2つのことを並行して行っています。実際の結果が判明するのを待つ一方で、その間に経験豊富なリスク管理の専門家が取引のサンプルを手作業で確認し、ラベル付けします。これにより、モデルは新しい学習データが必要になるたびに何週間も待つことなく、学習を続けられます。Karthikのチームは、このプロセスを適切に構築することが、モデル自体のどの要素よりも重要だと突き止めました。
不正対策チームは、AI不正検知エージェントの暴走をどのように防いでいるのでしょうか?
端的に言えば、各エージェントには必ず責任者が必要です。Imprintでは、すべてのエージェントについて、その動作に責任を負う担当者が明確に定められています。Intuitでは、KarthikのチームがAIと人間の審査担当者の判断一致率をリアルタイムで追跡しています。乖離が大きくなりすぎた場合は、原因を特定するまでエージェントの稼働を縮小または停止します。Slopeでは、Lawrenceが意図的に公開Slackチャンネル上で社内エージェントプラットフォームを運用しています。エンジニアは誤った回答をオープンな場で発見でき、チーム全体で「正しい」とは何かについて共通の判断基準を築けます。不正検知エージェントの監督は、一度設定すれば終わりという問題ではありません。継続的に取り組むべき運用上の責任です。
AI不正検知エージェントで誤検知が起こりやすいのはなぜですか?また、チームはどのように改善できますか?
エージェントを放っておくと、何でも疑わしいものとしてフラグを立てがちです。KarthikとLalithaは、こちらから尋ねるまでもなく、二人ともこの点を指摘しました。対策は、自社のビジネスにおける通常の取引行動が実際にどのようなものかを基準に、継続的に調整し直すことです。一度設定すれば終わりというものではありません。また、正解データの品質が性能の上限を決定します。ラベルが厳密さに欠けるレビューに基づいている場合、どれほど優れたモデルであっても、エージェントがそのレビューの精度を上回ることはできません。
中小企業向けの不正審査AIは、従来の信用審査とどのように異なる仕組みで機能しますか?
従来は、事業者に財務書類を提出してもらい、それを担当者が手作業で審査していました。時間がかかるうえ、不正に操作されやすい方法でした。SlopeのTransformerモデルは、オープンバンキングから生の取引データを直接取得し、自動的に財務指標へ変換します。さらにその上で、基盤モデルが各銀行取引をトークンのように扱い、言語モデルが次の単語を予測するのと同じように、次に何が起こるかを予測します。自己申告の書類ではなく実際の取引履歴に基づいているため、改ざんは格段に困難です。