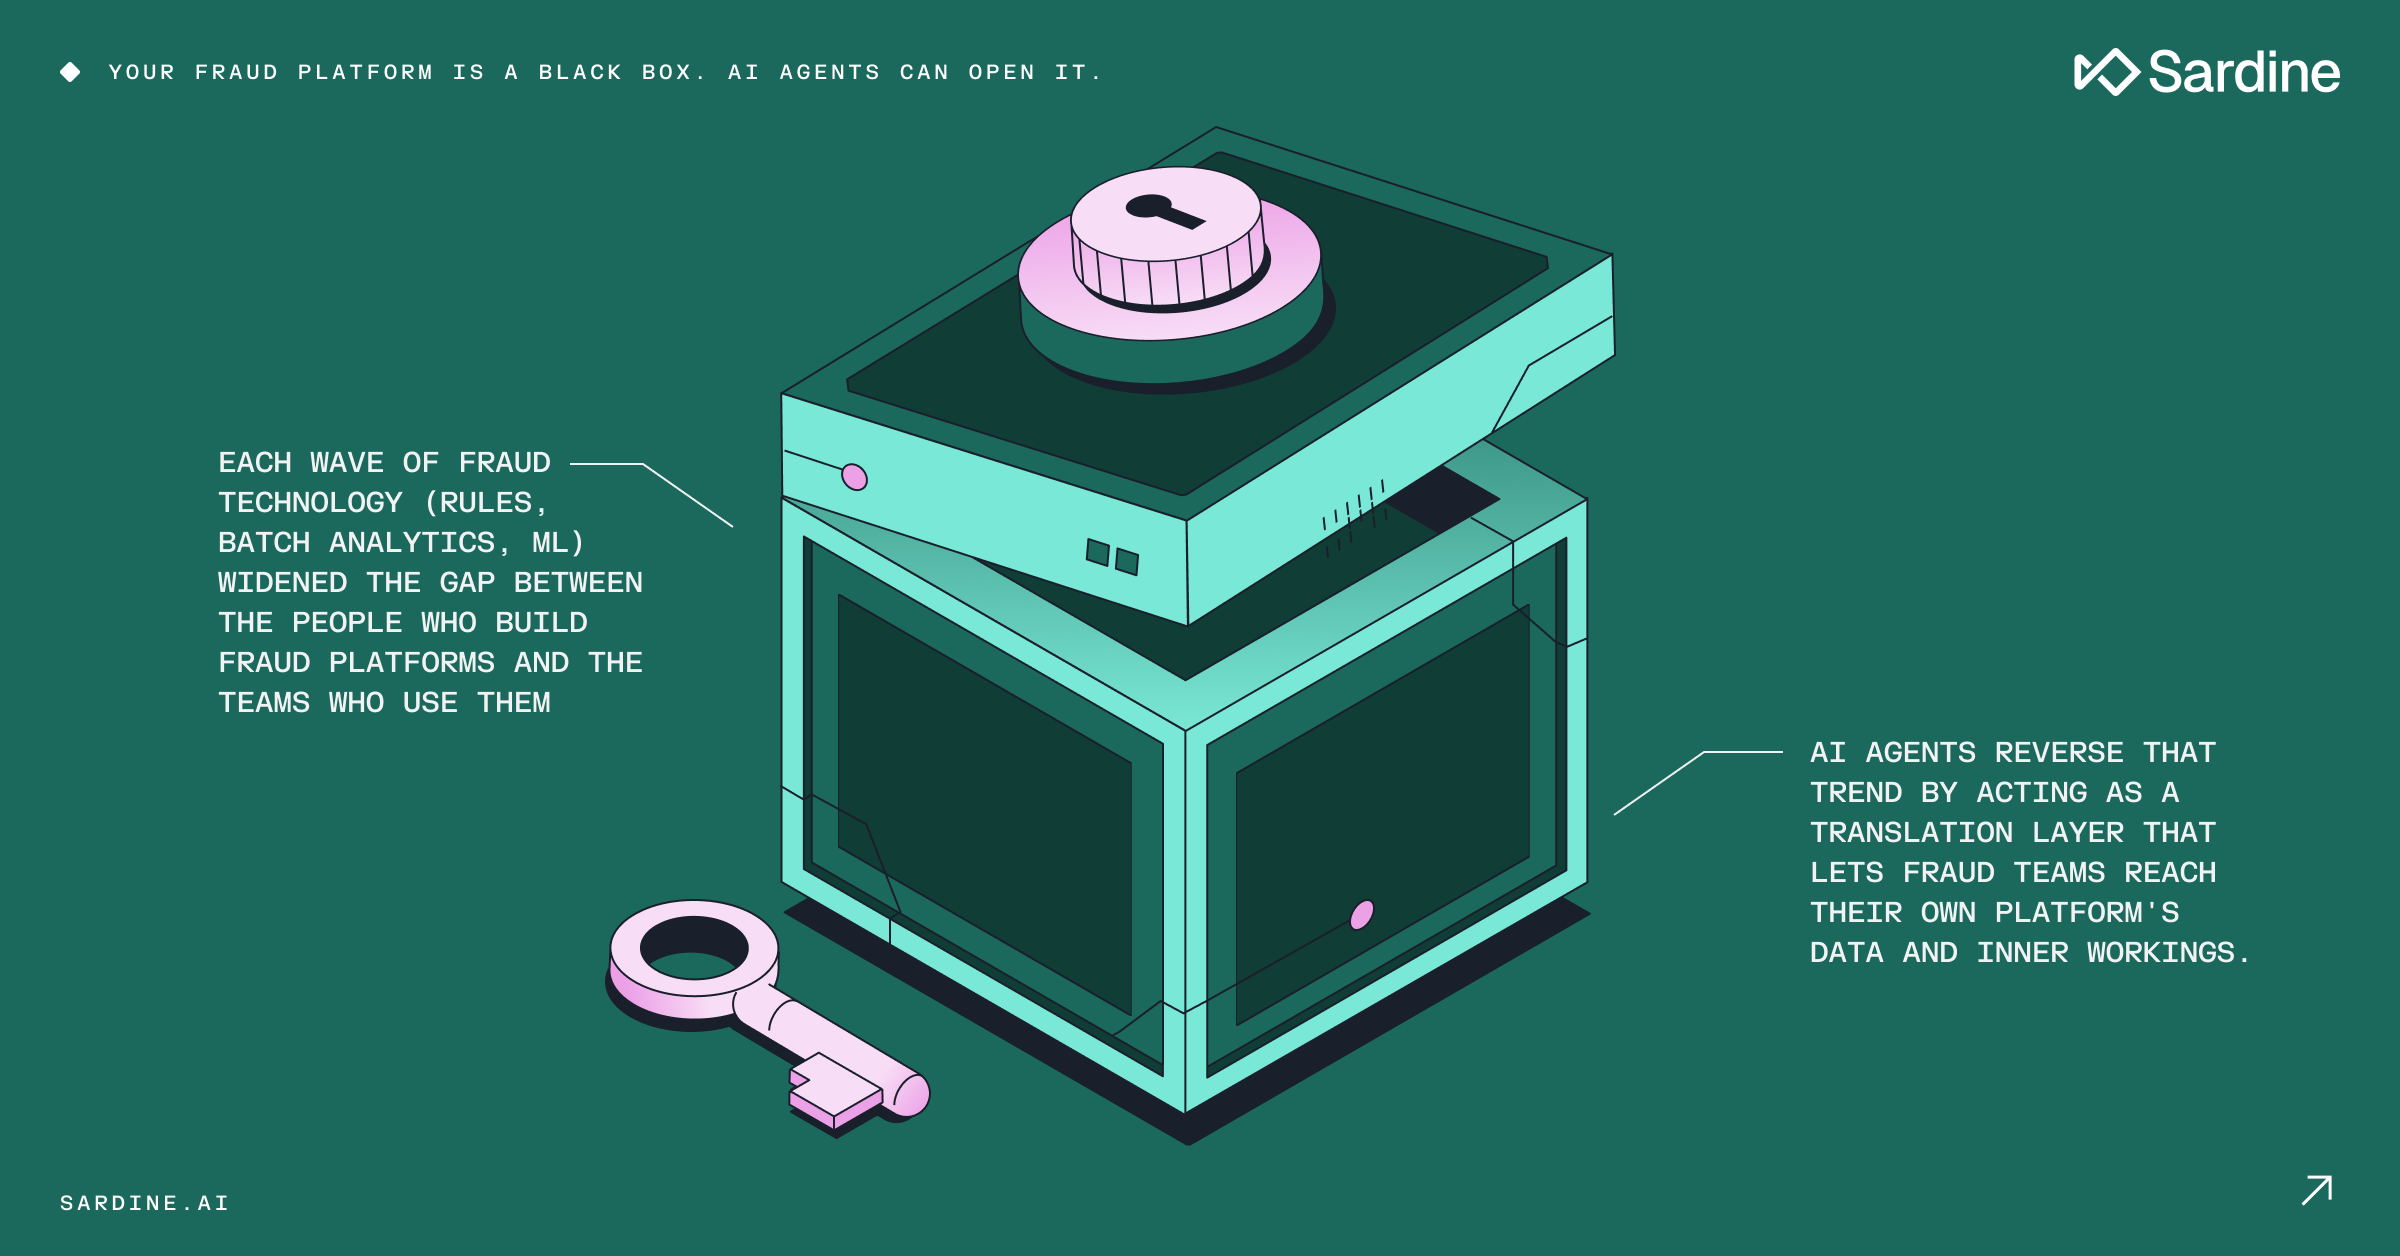
数年ごとに、不正防止の業務を容易にすると期待される新たなテクノロジーが登場します。ルール、バッチ分析、そして機械学習へと進化するたびに、不正対策プラットフォームはより強力になってきました。しかしその一方で、運用担当者に求められることも増えています。
その結果、必然的に、不正対策プラットフォームを構築する人々と、それを利用する不正対策チームとの間の隔たりは広がっていきます。AIによって業界に新たな技術革新の波が押し寄せている今、問うべきは、その隔たりがさらに広がるのかということです。
要点:プラットフォームが勝ち、あなたのチームが勝てない理由
- ルールベースから機械学習に至るまで、不正対策プラットフォームにおける大きな技術革新の波が訪れるたびに、プラットフォームを構築するチームと利用するチームの格差は広がってきました。ベンダーがデータやプラットフォームに関する知見へのアクセスを制限しているためです。
- 不正対策プラットフォームの開発者と実務担当者の間にある隔たりには、2つの根本原因があります。1つ目は、SQLやデータウェアハウスを含む不正対策プラットフォームへの直接アクセスがないことです。2つ目は、データスキーマ、特徴量の定義、モデルの仕組みなど、不正対策ベンダーのプラットフォームに関する知識が不足していることです。
- 不正検知AIのミドルウェアとして機能するAIエージェントは、アナリストの平易な依頼をプラットフォーム上の厳密な定義に変換し、不正スコアの感度チェックを実行し、観測されたパターンからルールを直接作成することで、ベンダーを介さずにこの傾向を逆転させます。
- 不正対策プラットフォームを選定する際の実践的な判断基準は、ベンダーのスタッフに頼らずに自社チームだけでどこまで運用できるかをベンダーに尋ねることです。その答えから、検討しているのが自立して使えるツールなのか、それともベンダーへの依存を生むものなのかが分かります。
不正対策プラットフォームの開発者と実務担当者のギャップ
あらゆる不正対策プラットフォームには、2つのグループが関わっています。構築者は、データ、特徴量、ルールエンジン、モデルを設計します。実務担当者は、日々プラットフォームを使用して監視や調査を行い、意思決定を実行するアナリストや不正対策マネージャーです。
構築担当者と実務担当者が同じ会社で働いていれば、プラットフォームがデータポイントをどのように算出しているのか分からないアナリストは、それを構築したエンジニアに質問でき、通常はその日のうちに回答を得られます。
しかし、プラットフォームがベンダーから提供されている場合、アナリストは料金を支払う顧客という立場です。ベンダーのエンジニアリングチームの隣に座って直接質問することはできませんし、ベンダー側にも、データやモデルの詳細の一部を非公開にしておく正当な理由があります。それこそが競争力の源泉だからです。
そのため多くの場合、企業はプラットフォーム全体に料金を支払っているにもかかわらず、結局は自社のチームが実際に理解できる部分しか使わなくなります。そして、不正防止業界の発展を振り返ると、この状況が時とともに悪化する一方だったことがわかります。
初期の不正対策ツールは、審査用の画面でした。取引やオンボーディング申請を行っている人物が誰で、何をしようとしているのかを調査担当者に示し、承認または却下の判断を記録するものでした。ソフトウェアは情報を表示するだけで、調査担当者は自身の判断に基づいてデータを照合・分析し、その事象にどう対処するかを決定していました。
その後、不正対策チームはその判断をルール化し、ルールエンジンがすべてのイベントに対してリアルタイムで実行するようになりました。ルールを使って不正パターンを阻止するには、そのパターンがプラットフォーム上のデータにどのように現れるかをアナリストが把握している必要があります。つまり、どのような特徴量があるのか(特徴量とは、1台のデバイスに紐づくアカウント数など、プラットフォームが算出する個々のデータポイントのことです)、それぞれが何を意味するのか、そしてそれらをどう組み合わせるのかを理解する必要があります。
高度な分析機能を使えば、アナリストは1日または1週間の終わりにバッチ処理で実行するジョブをスケジュールできました。これには、異常検知、アカウントをネットワークとしてクラスタリングする処理、そして取引が判定を待っている間に計算するには負荷が高すぎるパターンに関するレポートなどが含まれます。こうしたジョブを社内で実行しようとする場合、さらに高度な知識が求められました。プラットフォームがデータを整理・保存する仕組みであるデータスキーマを理解する必要がありました。また、データベースへの問い合わせに使われる標準言語であるSQL、またはスケジュールに従って実行されるコードでジョブを記述する必要もありました。
その後、ベンダーは各イベントにリスクスコアを付与する機械学習モデルを導入しました。あるイベントのスコアが高くなった理由を理解するのは比較的簡単ですが、そのスコアに基づいてどのような対応を取るかを決めるのは容易ではありません。プラットフォームがイベントを拒否または審査に回す基準となる、しきい値を設定する必要があります。単一のしきい値ですべての商品、地域、ユーザータイプに対応できることはほとんどないため、多くのチームでは複数のしきい値が必要になります。
セグメントごとにしきい値を設定するには、データへのアクセスと、それを照会するスキルが必要です。また、モデルがどの特徴量に依存しているかを把握し、しきい値を変化させた際に、正当なユーザーをどの程度拒否し、どの程度の不正を検知できるかを検証する感度分析も行う必要があります。そのためには、業務領域の専門知識、技術力、データへのアクセスが求められます。
しかし、業界の実情を冷静に見れば、独自のプラットフォームを構築している場合を除き、ほとんどの不正対策チームにはこうした能力が備わっていないと結論づけざるを得ません。
発電量 | ツールの機能 | 不正対策チームに求められること |
画面を確認する | 取引や申請を行っている調査担当者と、その担当者が何をしようとしているのかを表示し、承認または却下の決定を記録する | 判断。調査担当者がデータを照合し、各事象について一つひとつ手作業で推論します |
ルール | チームの判断基準をルールとして、すべてのイベントにリアルタイムで適用 | どのような特徴量が存在し、それぞれが何を意味し、どのように組み合わせるかを理解すること |
高度な分析 | 異常検知、アカウントのクラスタリング、リアルタイム処理には負荷が高すぎるレポート生成のために、スケジュールされたバッチジョブを実行する | データスキーマを理解し、SQLまたはスケジュール実行されるコードでジョブを作成する |
機械学習 | すべてのイベントにリスクスコアを付与する | セグメントごとにしきい値を設定するには、データへのアクセス、クエリのスキル、モデルが使用する特徴量の把握、感度分析が必要です |
プラットフォームに関する重要な知識はベンダーに握られている
不正対策チームに不足しているものを考えるとき、私たちはSQLやコーディングといった技術的なスキルに目を向けがちです。しかし、こうしたスキルは社内で育成することも、それを持つ人材を採用することもできます。一方、不正対策チームにとって満たすのがはるかに難しい要件がほかに2つあります。それは、ベンダーのデータに自由にアクセスできることと、プラットフォームの内部構造に関する知識です。
不正対策における最大の皮肉は、企業が不正対策ベンダーに料金を支払って利用しているものの多くが、自社のチームでは照会できないデータだということです。これには、ベンダーが独自に算出した特徴量、メールやデバイスインテリジェンスなどの専門プロバイダーから取り込んだシグナル、そして他の顧客から集約したコンソーシアムデータが含まれます。
同時に、不正対策チームは、プラットフォーム自体の運用方法に関する重要な知識が不足していることも少なくありません。プラットフォームに関する知識とは、ベンダーがデータをどのように整理し、特徴量をどのように構築しているか、モデルがリスクスコアをどのように算出するか、ルールがどのように実行されるかを理解することです。データに完全にアクセスできるチームであっても、この知識がなければ行き詰まってしまいます。
ベロシティ機能はその好例です。一定の時間枠内で何かが発生した回数をカウントします。たとえば、過去1時間に1台のデバイスから行われたカード決済の試行回数などです。その時間枠がローリング方式(常に直近60分間)か固定方式(毎正時にリセット)かによって、ルールの記述方法が変わります。正時をまたいで10回の試行が集中した場合、固定時間枠では2つの小さな集中として扱われるため、ローリング時間枠を前提に設計されたルールでは見逃す可能性があります。
あるいは、アナリストが新規登録で見つけたパターンを考えてみましょう。たとえば、johnd42 や sarahk17 のように、名、姓の頭文字、2桁の数字を組み合わせたメールアドレスです。アナリストは、このパターンを捉えられる特徴量があるのか、1つの特徴量で足りるのか、それとも複数の特徴量を組み合わせる必要があるのか、さらにルールエンジンで機能させるために、それらの特徴量を特定の方法で定義する必要があるのかを見極めなければなりません。いずれの答えも、ベンダーがプラットフォームをどのように構築したかによって異なります。
優れたベンダーなら、包括的なドキュメントやトレーニングセッション、個別の質問に対応するライブサポートをユーザーに提供しているはずだ、と考えるかもしれません。それは確かにそのとおりです。しかし、これほど複雑なシステムでは、ドキュメントとトレーニングだけでは到底十分とは言えません。
実際、ベンダーは長年にわたり、ダッシュボード、レポート、ドキュメント、トレーニング、カスタマーサクセスチームを通じて、この知識をユーザーに届けようとしてきました。しかし、こうした取り組みはいずれも、情報が少なすぎるか多すぎるかという同じジレンマに直面します。
データへのアクセスを提供するツールでは、増え続けるニーズに対応しきれません。不正の傾向は企業ごとに異なり、週ごとに変化するため、不正対策チームは既存のダッシュボードにはない新たなビュー、セグメント、フィルターを常に必要としています。どの企業にも尋ねたい個別の質問が数多くあり、ベンダーが質問ごとにレポートを作成することは不可能です。ましてや、顧客ごとに作成することなどできません。
ドキュメントには逆の問題があります。ベンダーは2,000項目すべてのデータポイントを文書化できますが、ルールを作成するアナリストが必要とするのはそのうちの1つだけです。優れた検索機能やフィルターがあっても、それを見つけて理解するのは容易ではありません。
その結果、不正対策チームには多くの指示やトレーニングが提供される一方で、明確な意思決定に最も必要な、データへの直接的なアクセスやデータを読み解くための支援はほとんど提供されていません。
エージェント型AIミドルウェアがこの傾向を逆転させる
開発者とユーザーの隔たりが広がり続けていることを考えると、AIによって複雑さがさらに増し、状況がいっそう悪化すると考えるのが自然です。しかし実際には、エージェント型AIはこの流れを逆方向へと転換します。
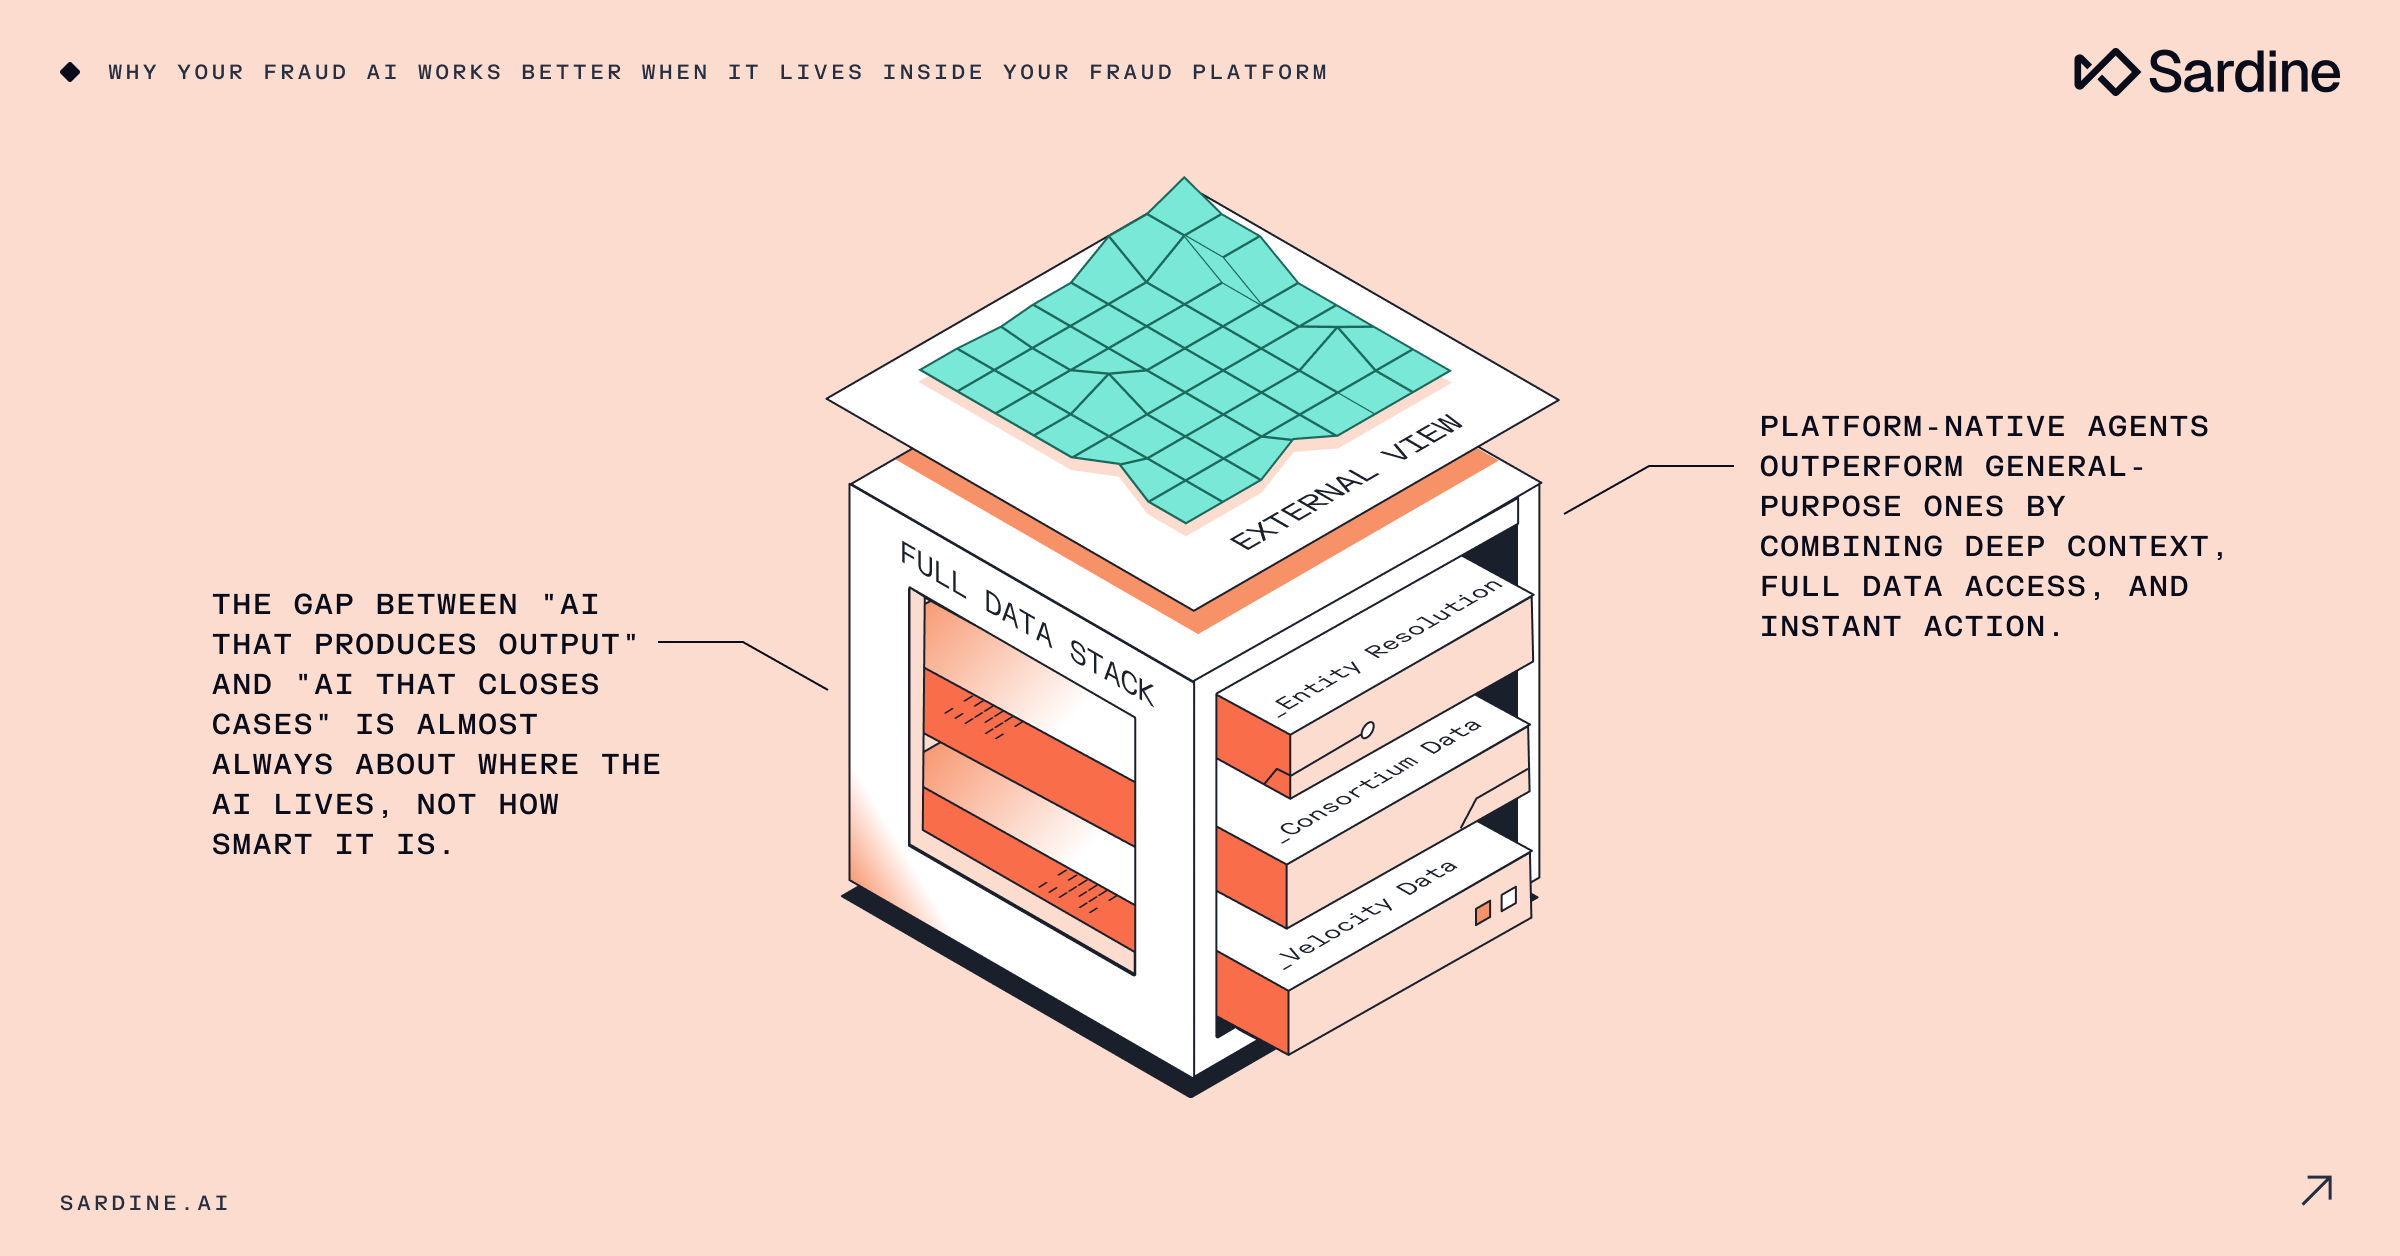
ベンダーはまず、自社のドキュメントを基盤として、不正対策プラットフォームにAI機能を組み込みました。これは、ユーザーがプラットフォームの仕組みについて質問できるアシスタントとして提供されたものです。ユーザーはより的確な回答を迅速に得られるようになり、ベンダーはAIがプラットフォームとその利用者をつなぐ「ミドルウェア」層として機能し得ることに気づきました。
しかし、AIエージェントは、これまでユーザーがまったく立ち入れなかった領域への道を開くこともできます。プラットフォーム内で拡張された「ミドルウェア」の役割を担うことで、ユーザーがプラットフォームとより効果的にやり取りし、操作できるようにします。エージェントは、平易な質問や要望をプラットフォームが求める厳密な定義に変換し、判断結果やレポート、必要なデータを返します。また、どのプロダクトチームも専用のダッシュボードを構築できないような、単発かつ企業固有の依頼にも対応できます。
例A:登録パターンに基づくAIによる不正検知ルールの作成
johnd42 や sarahk17 のようなメールアドレスで登録されたアカウントを見つけたアナリストを例に考えてみましょう。彼女はこのようなアカウントをいくつか発見し、これ以上増えるのを防ぎたいと考えています。
データアナリストエージェントは、彼女がフラグを付けたアカウントを対象に、2つの処理を行います。まず、同じパターンに一致するアカウントをさらに検索し、分析に使えるデータを増やすとともに、対応対象となるアカウントの範囲を広げます。さらに、データスキーマを調べて、そのパターンを表す正確な特徴と値を特定します。これにより、彼女による大まかな説明(名、姓の頭文字、2桁の数字)が、プラットフォーム固有の「語彙」に基づく厳密な定義へと変換されます。
次に、ルール作成エージェントがそれらの調査結果を、プラットフォームのリアルタイム・ルールエンジンで使用するルールに変換します。これはデータベースクエリの作成とは異なる作業です。リアルタイム環境では、これらの特徴量に異なる命名規則が使われていたり、一部がまったく存在しなかったりするためです。また、このエージェントは、正当なユーザーの拒否を最小限に抑えながら不正を最大限検知できるようルールを調整し、誤検知を低く抑えることもできます。
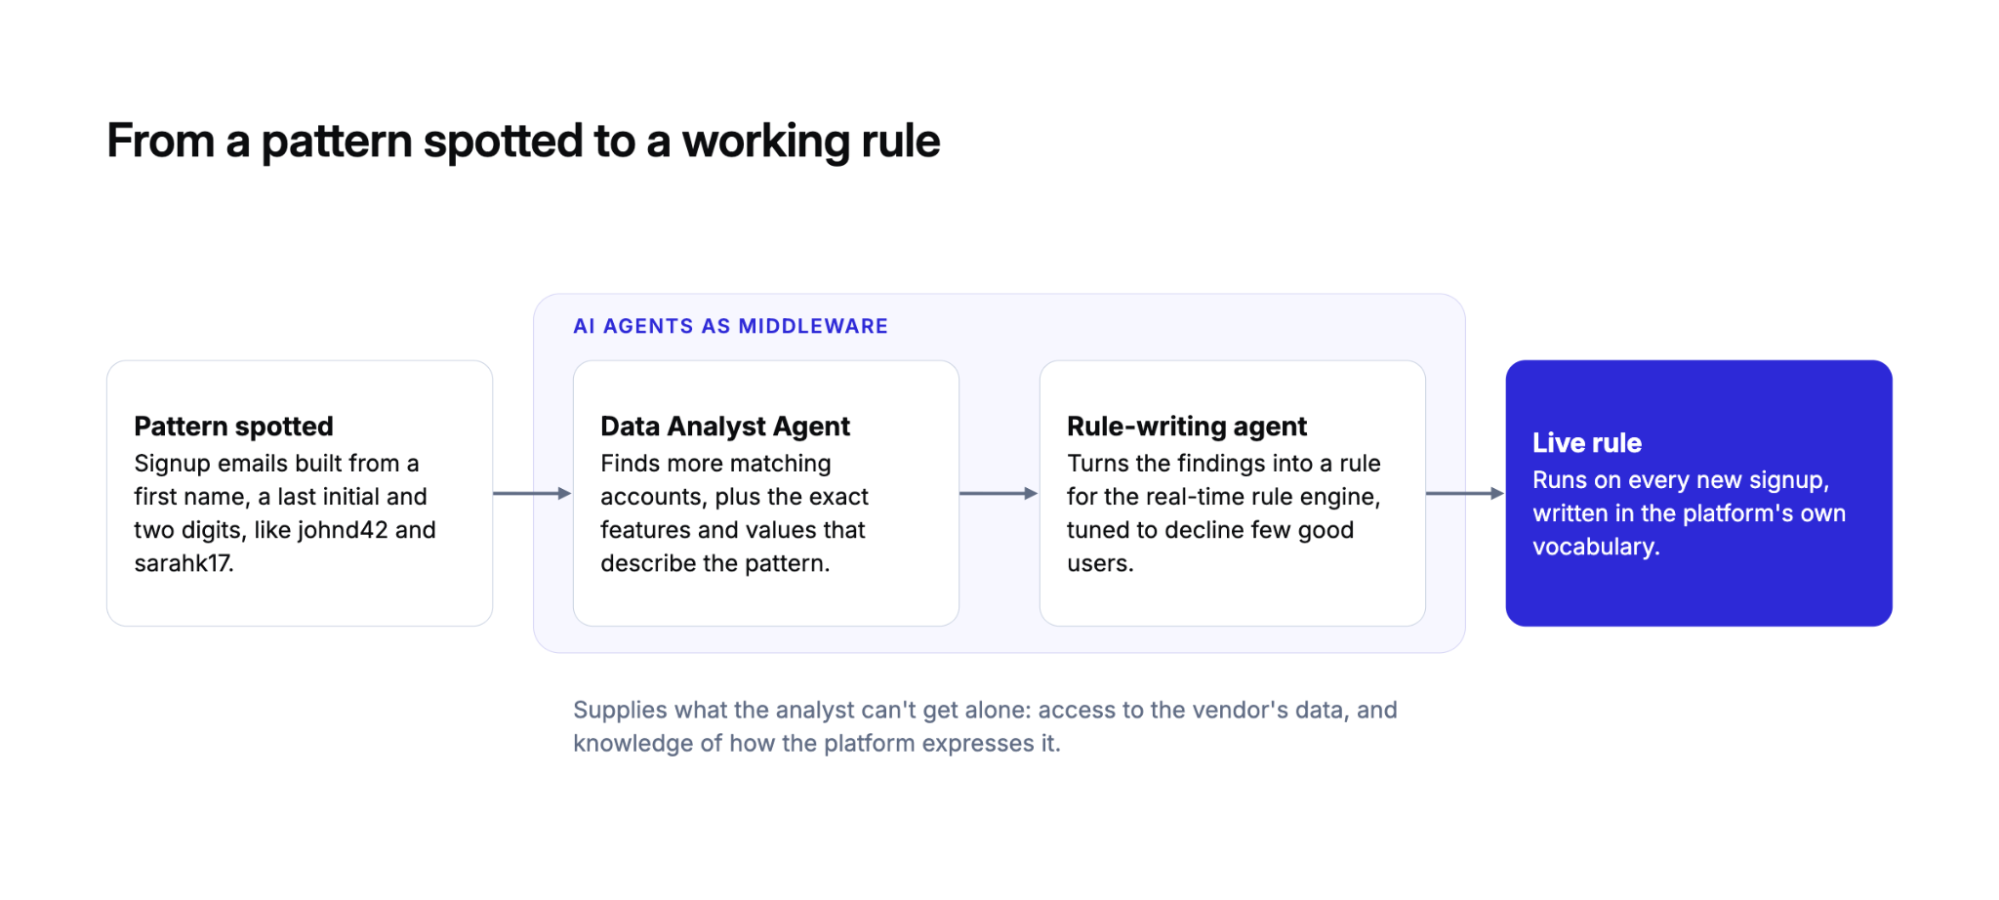
AIは、アナリストが自力では得られない2つのもの、すなわちベンダーのデータへのアクセスと、そのデータがプラットフォーム上でどのように表現されるかについての知識を提供します。
Sardineでは、ルールアシスタントエージェントとデータアナリストエージェントが、プラットフォーム内でこの作業を行います。不正対策チーム向けのAIエージェントの仕組みをご覧ください。
例B: セグメント別の不正スコアしきい値の設定
同じアプローチは、機械学習をより効果的に活用する場合にも有効です。たとえば、不正対策担当者がモデルの取引拒否しきい値をどのように設定すべきか知りたいとします。その場合、データ分析エージェントに依頼して、ユーザー層をプロダクトフロー(登録、決済、出金)、地域、支払い方法、アカウント種別などの主要なセグメントに分けることができます。
各セグメントについて、エージェントが感度分析を実行し、マネージャーが選んだ目標を最もよく満たすしきい値を特定します。目標には、特定の拒否率、適合率、再現率などを設定できます。また、保守的なものから積極的なものまで、3段階のリスク許容度で同じ分析を依頼し、推奨されるしきい値を一覧表で比較することもできます。
この分析を行うには、以前はデータスキーマに関する知識や感度分析の実施経験に加え、何よりも、ほとんどのチームには与えられていない不正検知ベンダーのデータウェアハウスへのアクセス権が必要でした。そのため、実施を諦めるか、通常は費用を払ってベンダーに依頼するしかありませんでした。しかし、エージェントを活用すれば、不正対策チームが自ら分析を実行して判断を下し、不正の傾向が変化しても、ベンダーを待つことなく毎月繰り返し実施できます。
注目すべきAI機能
これまでのテクノロジーの波は、そのたびに不正対策プラットフォームと、それを利用するチームとの距離を広げてきました。AIエージェントは今、その距離を縮め始めており、これまでのところ最大の効果は、企業がすでに費用を支払っているプラットフォームをこれまで以上に有効活用できるよう支援していることです。
これにより、開発者が提供できるものも変わります。運用担当者の負担を増やすことなく、より高度な検知機能を追加できるからです。
事態は深刻です。Trustpairによる2026年の不正動向調査では、財務部門の上級意思決定者の58%が、詐欺師の手口は今や人間が対応できる速度を上回って進化していると考えていることが明らかになりました。
不正対策プラットフォームを選ぶ際、AI対応を確認するのは当然の出発点ですが、それだけでは漠然としすぎています。次に問うべきは、そうした機能によってチームがプラットフォームをより有効に活用できるのか、それとも、チームがデータにアクセスできず、仕組みも把握できず、そのどちらも明確な意思決定に生かせないまま、プラットフォームがブラックボックスであり続けるのか、という点です。
その定義に照らせば、モデルについて十分な説明がなされている不正対策プラットフォームの多くも、依然としてブラックボックスです。
プラットフォームのデータや内部の仕組みを自社チームに開示するAIであることは、特に重視すべきポイントの一つです。ベンダーとの打ち合わせで簡単に確認するには、ベンダーのスタッフの支援なしで、自社チームだけでプラットフォームをどこまで運用できるかを尋ねてみるとよいでしょう。
その答えを聞けば、プラットフォーム全体を購入することになるのか、それともチームが利用できる10%だけなのかが分かります。
さらに詳しくは、金融犯罪対策チームが特定のプラットフォームに依存せずに運用できるようにする「金融犯罪対策において信頼できるAIエージェントを導入する方法」をご覧ください。
よくある質問
不正対策プラットフォームのブラックボックス問題とは何ですか?
不正対策プラットフォームに費用を支払っているチームが、そのデータにアクセスできず、モデルが各イベントをどのようにスコアリングしているかを理解できず、さらにベンダーの支援なしでは、その理解を実用的なルールや意思決定に落とし込めない場合、そのプラットフォームはブラックボックス化しています。この問題は時間とともに深刻になります。ルール、バッチ分析、機械学習といった新たな技術レイヤーが加わるたびに、効果的な運用に必要な技術力と、そのプラットフォーム固有の知識が増えていくためです。
不正検知AIミドルウェアとは何ですか?また、どのように役立ちますか?
不正対策AIミドルウェアは、不正対策チームとベンダープラットフォームの間に位置するAIエージェント層です。自然言語による依頼をプラットフォーム内部の定義に変換し、ベンダーのデータを直接照会して、実際に利用できるルールやレポート、しきい値の推奨案を返します。これにより、不正対策チームは、これまでベンダーの担当者を介さなければ利用できなかったプラットフォームの機能にアクセスできるようになります。
パターンに基づくAI不正検知ルールの作成は、実際にはどのように行われますか?
不正分析担当者が、予測可能な規則で生成されたメールアドレスなどの疑わしいパターンを特定し、それを平易な言葉でデータ分析エージェントに説明します。エージェントはプラットフォームのデータを検索して、そのパターンに一致する他のアカウントを見つけ、プラットフォームのスキーマ上でパターンを定義する具体的な特徴と値を特定します。その結果をルール作成エージェントに渡すと、同エージェントがリアルタイムルールエンジンで動作するルールを作成し、正当なユーザーへの影響を最小限に抑えるために不正検知ルールの誤検知も調整します。
不正スコアのしきい値設定とは何ですか?また、なぜデータへのアクセスが必要なのですか?
不正スコアのしきい値を設定するとは、プラットフォームがイベントを拒否または審査に回す基準となるスコアを決めることです。単一のしきい値ですべての商品、地域、ユーザータイプに対応できることはほとんどないため、多くのチームでは複数のしきい値が必要になります。また、しきい値を変更した際に、正当なユーザーがどれだけ拒否され、どれだけの不正を検知できるかを示す不正スコアの感度分析を、それぞれについて行う必要があります。この分析には、ベンダーのデータウェアハウスへのアクセスと、プラットフォームのデータスキーマに関する知識が必要です。しかし、ベンダーの協力なしにこれらを備えている不正対策チームは、ほとんどありません。
不正対策プラットフォームによって、チームが真の自立性を確保できるかどうかを評価するには、どうすればよいですか?
ベンダーのスタッフに頼らずに、自社チームだけでプラットフォームをどこまで運用できるのか、ベンダーに直接確認してください。データクエリ、ルールの調整、しきい値の設定、機能の解釈のたびにベンダーへの依存が必要なプラットフォームは、ツールではなくベンダーロックインのリスクです。一方、AIエージェントを通じて、自社チームが不正対策プラットフォームやSQLに直接アクセスでき、スキーマレベルの知識も得られるプラットフォームであれば、不正対策に求められるスピードで実際に運用できます。
現在の環境が、ベンダーの立ち会いなしでどの程度運用できるかを確認するには、Sardineチームまでお問い合わせください。