

Sardine では、Protocol Buffers(プロトコルバッファ)(protobuf)をあらゆる場面で使用しています。これは、型情報を持ち、軽量で言語に依存しないシリアライズ形式です。
私たちは、BigQuery テーブルのデータスキーマを定義するために protobuf を使用し、同じ protobuf ファイルからバックエンドサーバー(Go)のコードも生成しています。バックエンドサーバーは、protobuf から生成された Go の構造体にデータを詰めて pubsub に送信し、その後 dataflow ジョブがそれらを BigQuery で取り込みます。
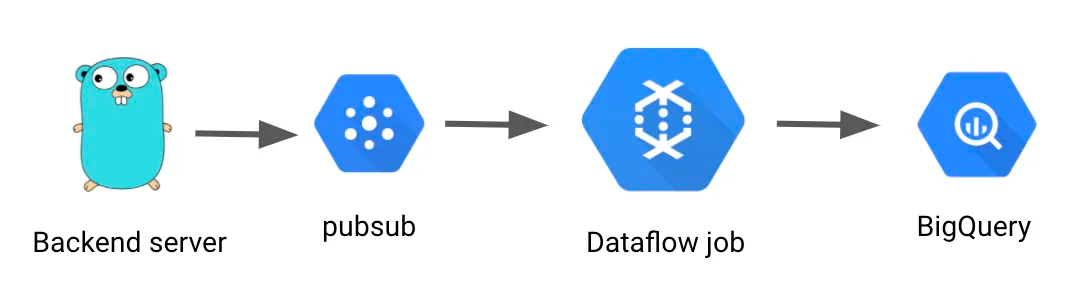
このシンプルなパターンは概ねうまく機能しましたが、ひとつだけ問題がありました。開発を始めた当時、pubsub オブジェクトを BigQuery の行挿入用データに変換する明確な方法がなかったため、あるオブジェクトから別のオブジェクトへデータをコピーするために、以下のようなボイラープレートコードを書く必要がありました。
TableRow clientMetadataRow = new TableRow() .set("session_key", clientMetadata.getSessionKey()) .set("client_id", clientMetadata.getClientId()) .set("revision", clientMetadata.getRevision()) .set("user_id", clientMetadata.getUserId())...
これはとても面倒で、ミスも起こりやすい作業でした。bigquery のテーブルに新しいフィールドを追加するたびに、上記のボイラープレートコードも更新しなければなりませんでした。これには、もっと良い解決策があるはずです。
(補足 — もし今日新しくサービスを立ち上げるのであれば、pubsub のシリアライズ形式として protobuf の代わりに JSON を使い、そのうえで Google 公式の pubsub-to-bigquery ジョブテンプレート(ベータ版)を利用することもできます —https://cloud.google.com/dataflow/docs/guides/templates/provided-streaming)
実は、protobuf オブジェクトは動的に反復処理できるので、フィールド名をハードコーディングする代わりに、次のようなことができます。
void copyFields(GeneratedMessageV3 fromProto, TableRow toRow) { allFields = fromProto.getDescriptorForType().getFields(); for (Descriptors.FieldDescriptor field: allFields) { Object value = fields.get(field); String columnName = field.getName(); switch (field.getJavaType()) { case STRING: if (value != null) { toRow.set(columnName, value); } break;...
以上です!このおかげでボイラープレートコードが減り、Javaコードを更新する心配をしなくてよくなりました(ただし、スキーマを変更した場合は、ジョブランナーが最新のproto定義を認識できるように、dataflowジョブを再デプロイする必要がある点には注意してください)
私たちは、コミュニティが一から作り直さなくて済むように、以下のリポジトリでコードを公開しました — https://github.com/sardine-ai/proto-to-bq-java
何かフィードバックがありましたら、ぜひ私までご連絡ください。https://twitter.com/kazukinishiura
私たちはあらゆるエンジニア職で採用を行っています — https://www.sardine.ai/careers