

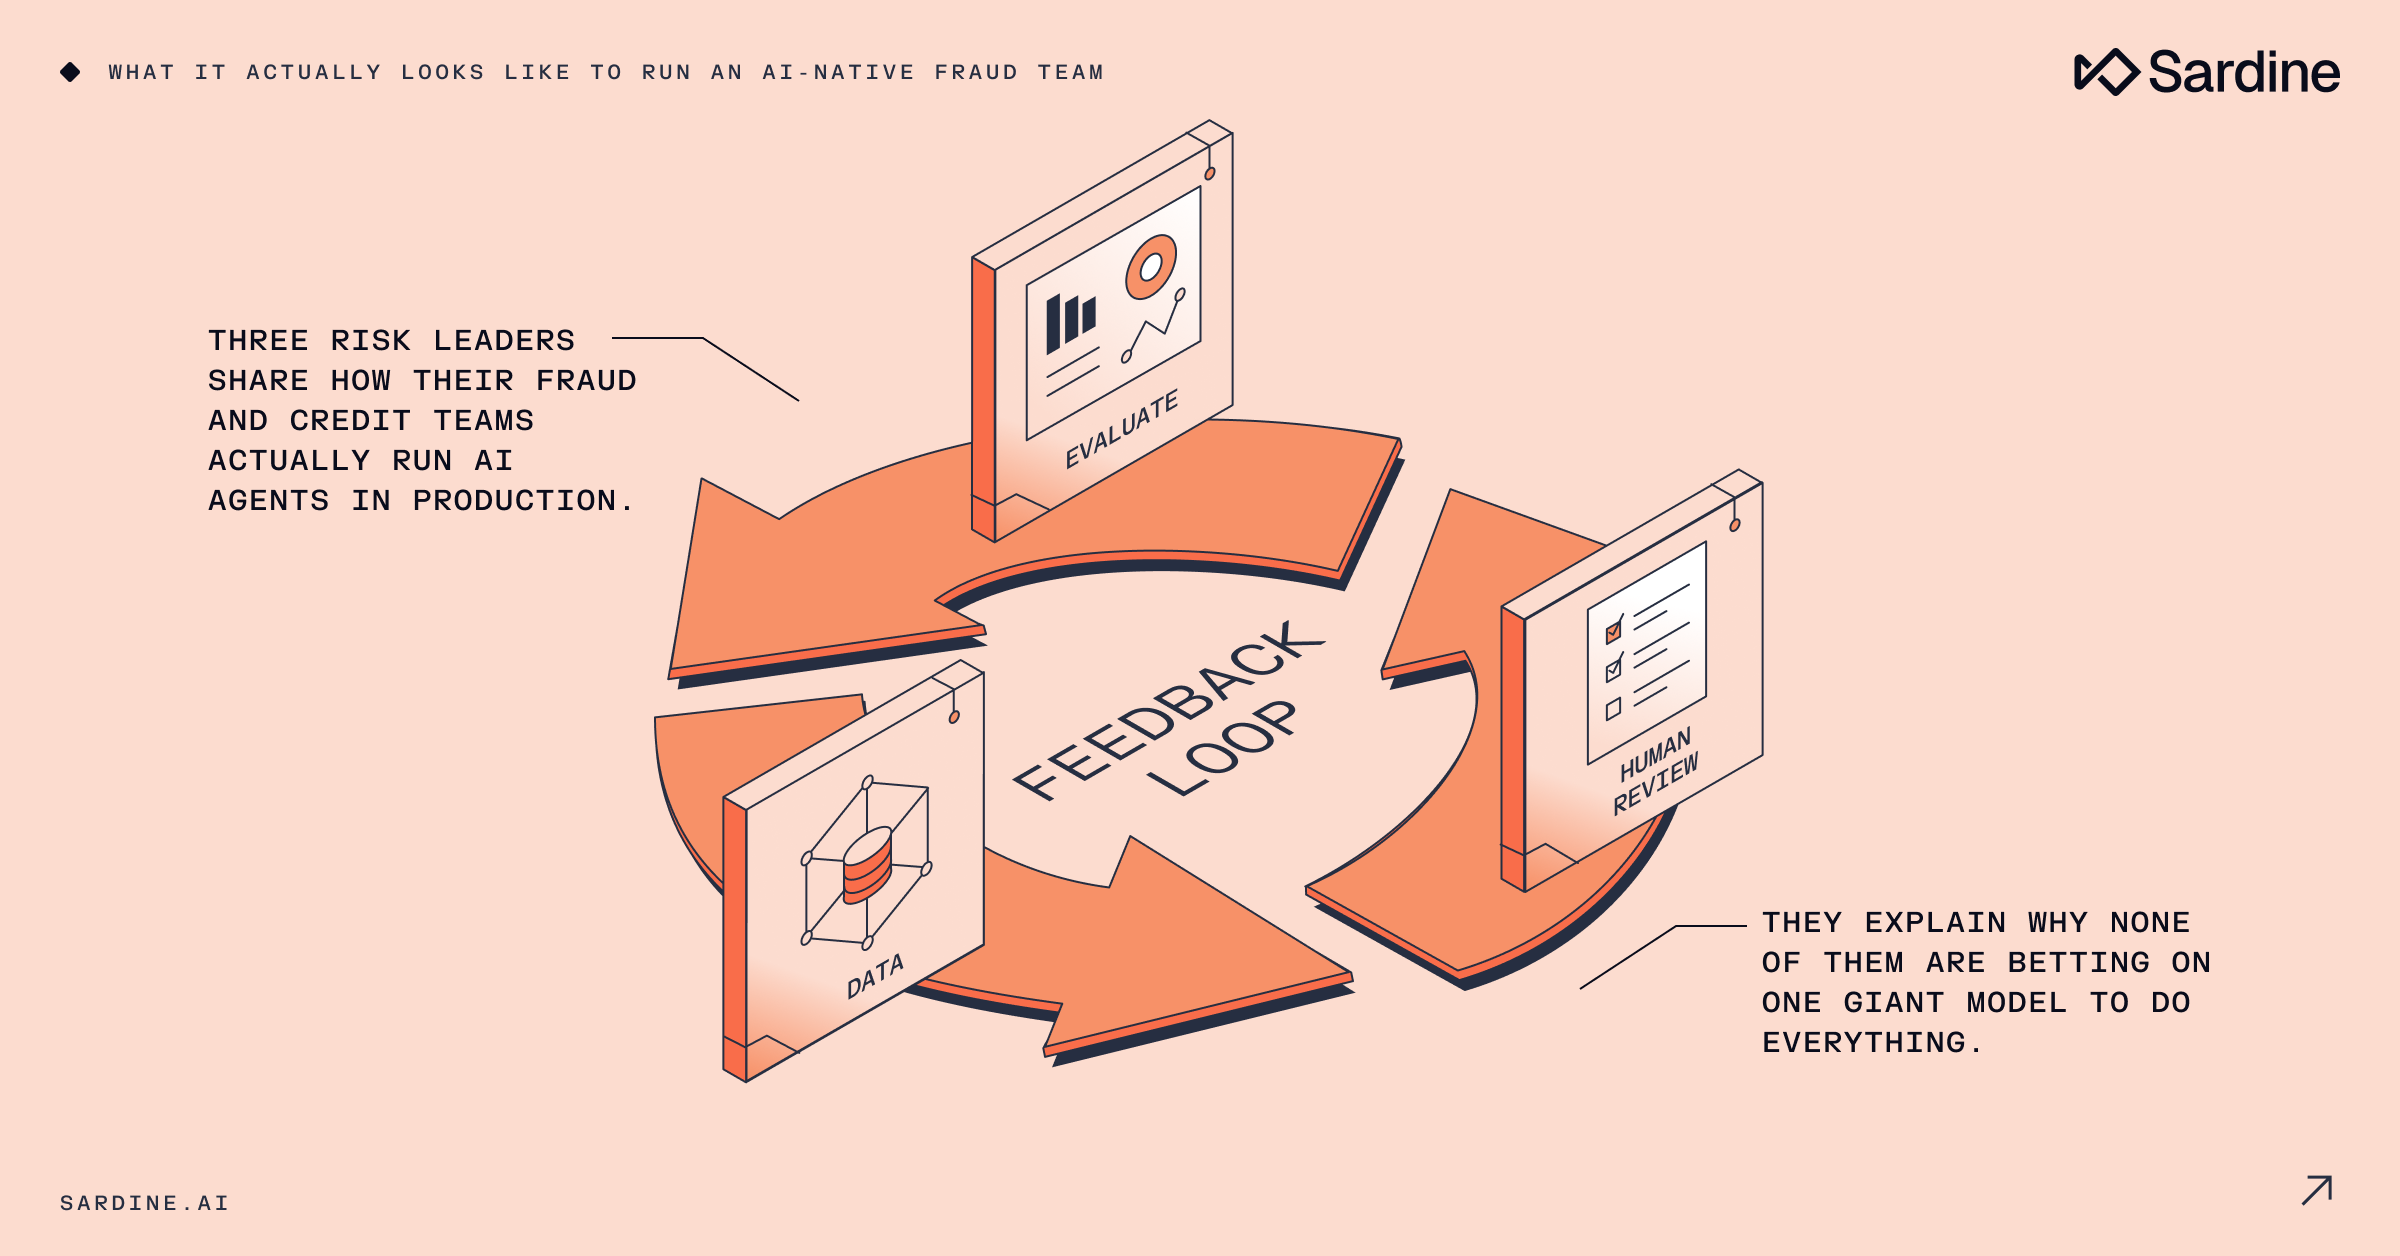
Conclusiones clave:
- El rol del analista de fraude cambió antes que el organigrama. En Imprint, las tediosas tareas de supervisión y gobernanza ahora están automatizadas, lo que permite a los analistas dedicar más tiempo a detectar nuevos patrones de fraude e incorporarlos de nuevo a los modelos.
- La calibración de los agentes de IA para la detección del fraude es un requisito continuo, no una configuración que se realiza una sola vez. Si no se supervisan, estos agentes marcan todo como sospechoso y los falsos positivos anulan los beneficios.
- El verdadero producto del agente de facturación de Intuit resultó ser el ciclo de retroalimentación del agente antifraude, no el modelo en sí. Un menor número de señales, pero más concluyentes, dio mejores resultados que un gran volumen.
- La calidad de las etiquetas de fraude determina el límite máximo. Si los datos de referencia provienen de revisiones menos rigurosas, el agente nunca podrá superarlas. Imprint evalúa el rendimiento del agente comparándolo con especialistas en fraude debidamente capacitados, no con revisores promedio.
- Nadie que dirija un equipo de fraude nativo de IA apuesta por un único gran modelo de propósito general. Las tres empresas coincidieron en utilizar agentes especializados construidos sobre una infraestructura común, y cada equipo de dominio se encarga de los agentes pertinentes para su trabajo.
En SardineCon, reunimos en el escenario a tres líderes de riesgo que viven esta realidad a diario: Karthik, responsable de riesgo de pagos en Intuit; Lawrence, de Slope; y Lalitha, de Imprint. Entre el riesgo de pagos, la evaluación crediticia de pymes y el crédito al consumo y el fraude, el panel abordó muchos temas. Sin embargo, las mismas ideas surgieron una y otra vez: los flujos de trabajo diseñados para personas no funcionan para los agentes, los ciclos de retroalimentación importan más que la arquitectura del modelo y ninguno de los participantes pretende crear un único modelo que lo controle todo.
Esto es lo que más destacó.
El rol del analista de fraude cambió antes que el organigrama
Todos los panelistas describieron el mismo cambio: dedicar menos tiempo a la supervisión manual y al seguimiento de los SLA, y más al trabajo que realmente requiere criterio.
En Imprint, Lalitha afirmó que el día a día de un analista de riesgos es «completamente distinto» al de hace cuatro meses, porque gran parte del tedioso trabajo de supervisión y gobernanza ahora está automatizado. Esto permitió al equipo dedicar más tiempo a tareas estratégicas y orientadas al crecimiento. En Intuit, Karthik describió algo similar a nivel organizativo: las antiguas fronteras entre estrategia, previsión y análisis se están difuminando, y ahora los analistas se responsabilizan de los resultados de principio a fin, en lugar de transferir el trabajo de una función a otra.
Ninguno de los panelistas planteó esto como una sustitución de personal. Lalitha afirmó directamente que el objetivo es permitir que el equipo amplíe su capacidad sin aumentar la plantilla de forma proporcional. De este modo, lo ideal es que los analistas puedan dedicar su tiempo a detectar nuevos patrones de fraude e incorporarlos a los modelos, en lugar de realizar tareas de revisión repetitivas. Karthik señaló algo relacionado: los agentes de IA de Intuit pueden encargarse de revisar cuentas las 24 horas del día, sin el tiempo de adaptación ni la variabilidad de competencias que conlleva un equipo humano en crecimiento.
La arquitectura de Slope para evaluar el riesgo de fraude en pymes: las transacciones como tokens
Lawrence ofreció la explicación técnica más clara de la jornada. Antes, el proceso de evaluación de riesgos de Slope dependía de que los propietarios de pymes presentaran sus estados financieros para una revisión manual, un proceso lento y tedioso. Slope Transformer, su primer modelo, cambia este enfoque al procesar directamente datos brutos de transacciones de banca abierta y convertirlos en métricas financieras. Como los datos proceden de transacciones bancarias reales y no de documentos declarados por los propios solicitantes, son mucho más difíciles de falsificar.
La capa más interesante se encuentra por encima: un modelo fundacional que trata cada transacción bancaria como un token y predice qué viene después, de forma similar a como los modelos de lenguaje predicen la siguiente palabra. Esto permite a Slope prever si un determinado flujo de ingresos o gastos probablemente se repetirá, cuándo lo hará y por qué importe. Este sistema ha demostrado superar al anterior enfoque basado en reglas que Slope ejecutaba en modo paralelo antes de poner el nuevo modelo en producción.
Lawrence tuvo cuidado de separar el trabajo de modelado del trabajo de cumplimiento normativo. El modelo de probabilidad de impago que realmente toma las decisiones crediticias debe seguir siendo plenamente explicable, y Slope garantiza que las notificaciones de medidas adversas y la información regulatoria cumplan la legislación aplicable en nombre de su banco asociado, Lead Bank.
Los agentes antifraude en tiempo real de Imprint, en cifras
Lalitha compartió algunas de las cifras más contundentes del panel. Imprint utiliza agentes en tiempo real que detectan patrones de fraude emergentes y proponen soluciones, ya sea endurecer una regla o desarrollar una nueva funcionalidad. Cada ejecución de un agente abarca unas seis horas y realiza un trabajo que, de otro modo, le llevaría nueve días a un analista, con un coste en tokens de unos pocos cientos de dólares. Lalitha afirmó que esto se traduce en cientos de miles de dólares en pérdidas por fraude evitadas cada mes.
El problema es que los agentes, si no se supervisan, tienden a marcarlo todo como sospechoso. Tanto Karthik como Lalitha señalaron que este patrón se repite en sus equipos: es necesario recalibrar activamente los agentes para que reconozcan cómo es realmente el comportamiento normal de las transacciones; de lo contrario, los falsos positivos anulan los beneficios.
El agente de IA para facturas que nadie esperaba
Karthik explicó cómo los analistas de Intuit crearon un agente que se ejecuta cada hora y analiza todas las facturas que pasan por la plataforma de facturación de QuickBooks para evaluar si parecen corresponder a un pago anticipado, un servicio completado, un importe inflado o algo aparentemente inventado. No determina directamente si se trata de un fraude, sino que asigna una calificación de riesgo que sirve como una señal más, entre varias, para los agentes posteriores encargados de tomar decisiones sobre fraude y crédito.
La conclusión a la que Karthik volvió una y otra vez es que tener más datos no siempre es mejor. Al principio, Intuit proporcionó al modelo toda la información disponible y, como resultado, se encontró con un problema de relación señal-ruido. Un menor número de señales, pero más concluyentes, dio mejores resultados que un gran volumen de datos, y el verdadero producto resultó ser el ciclo de retroalimentación, no el modelo en sí.
Dos tipos de etiquetas y un listón más alto que el del «analista promedio»
El enfoque de retroalimentación de Intuit se basa en dos tipos de etiquetas. Las etiquetas finales proceden de resultados del mundo real —contracargos, cierres de cuentas—, es decir, del tipo de datos verificados que tardan en materializarse. Mientras tanto, las etiquetas sintéticas provienen de profesionales de riesgos con experiencia que anotan manualmente transacciones de muestra. Karthik afirmó que combinar ambos tipos permite que el modelo reciba señales con mayor rapidez y, al mismo tiempo, genera un registro de auditoría que los responsables de gobernanza y cumplimiento pueden revisar.
Imprint sigue una filosofía similar y fija deliberadamente un listón muy alto al comparar el rendimiento del agente con el de especialistas en fraude debidamente capacitados. La observación de Lalitha es que la calidad de las etiquetas determina el máximo nivel que se puede alcanzar; por tanto, si los datos de referencia provienen de revisiones menos rigurosas, el agente nunca podrá superarlas.
Nadie apuesta por que un solo modelo lo haga todo
Karthik resumió la conclusión a la que llegó el grupo en cuanto a la arquitectura. Nos encontramos en un momento en el que se ha enfriado el entusiasmo inicial del sector por un único modelo grande y de propósito general capaz de abordar todos los casos de uso. Si se proporciona demasiado contexto a un modelo, se obtiene ruido, no precisión. Las tres empresas coincidieron en adoptar una infraestructura compartida para agentes que funciona con cualquier modelo de vanguardia, sobre la cual los equipos especializados —crédito, fraude y operaciones— desarrollan sus propios agentes especializados aprovechando su experiencia.
Esa preferencia por la especialización volvió a ponerse de manifiesto en la conversación sobre los datos propios. Los tres panelistas afirmaron que preferían desarrollar sus soluciones internamente antes que entregar sus datos a un laboratorio de modelos de vanguardia. Lawrence explicó que un modelo más pequeño, entrenado con los datos de Slope, puede igualar la precisión de un modelo de vanguardia y, al mismo tiempo, superarlo en latencia y coste. Lalitha destacó la posición de Imprint como intermediario entre el comercio y el cliente, lo que les proporciona datos de comportamiento realmente difíciles de falsificar: a diferencia de una identidad robada, un historial inventado de relación con un socio concreto no resiste el escrutinio. El equipo de Karthik compra señales externas, pero mantiene la toma de decisiones dentro de la empresa, en parte porque las relaciones anteriores con proveedores implicaban un flujo de datos unidireccional que nunca llegó a mejorar los modelos de Intuit.
Dónde falló y cómo lo detectaron
Cuando se les preguntó directamente por los puntos débiles, los integrantes del panel no eludieron la cuestión. Lalitha describió unos resultados iniciales que eran interesantes, aunque no siempre precisos, y afirmó que «Claude se equivocó» había dejado de ser una respuesta aceptable dentro de la empresa. Ahora, cada agente tiene asignada una persona responsable de lo que hace.
El equipo de Karthik supervisa en tiempo real el grado de coincidencia entre los agentes de IA y los humanos, y cualquier desviación significativa hace que se reduzca la actividad del agente o se suspenda por completo. El enfoque de Lawrence apuesta por la transparencia: la plataforma interna de agentes de Slope funciona en canales públicos de Slack. Esto permite a los ingenieros detectar abiertamente las respuestas incorrectas y al equipo desarrollar de forma conjunta un criterio compartido sobre qué es realmente correcto.
La conclusión
En los ámbitos del riesgo en pagos, la evaluación crediticia de pymes y el crédito y fraude al consumidor, se repetían los mismos principios operativos. Los flujos de trabajo deben automatizar las tareas tediosas para que las personas puedan centrarse en las decisiones que requieren criterio, establecer ciclos de retroalimentación sólidos antes de confiar una decisión real a un modelo, exigir a los agentes un nivel de desempeño superior al de un revisor humano promedio y resistir la tentación de usar un único modelo que intente hacerlo todo. Este enfoque ya está implementado en tres empresas, no como prueba de concepto, sino en entornos de producción reales. Y los equipos que aplican este método no se limitan a mantener el ritmo: sus analistas gestionan más casos sin aumentar la plantilla.
Preguntas frecuentes sobre un equipo de fraude nativo de IA
¿Cómo es un equipo de fraude nativo de IA en producción?
Un equipo de fraude nativo de IA utiliza agentes especializados para tareas concretas, como la detección de anomalías, la creación de reglas, la evaluación del riesgo de las facturas y la investigación de casos, en lugar de recurrir a un único modelo de propósito general. Los equipos de Intuit, Slope e Imprint llegaron a la misma conclusión. En vez de intentar que un solo modelo se encargue de todo, los equipos crean agentes diseñados específicamente para funciones determinadas. Cada área de la empresa se responsabiliza de los agentes pertinentes para su trabajo.
¿Cómo mejoran los ciclos de retroalimentación de los agentes antifraude el rendimiento del modelo con el tiempo?
El ciclo de retroalimentación es lo que permite que todo el sistema mejore con el tiempo. Lo complicado es que, a menudo, no se sabe de inmediato si una decisión sobre fraude fue correcta. Los contracargos y los cierres de cuentas pueden tardar semanas en producirse. Por eso, el equipo de Intuit hace dos cosas en paralelo: espera a que lleguen esos resultados reales y, mientras tanto, profesionales con experiencia en riesgos revisan manualmente transacciones de muestra y las etiquetan. De este modo, el modelo sigue aprendiendo sin tener que esperar semanas cada vez que necesita nuevos datos de entrenamiento. El equipo de Karthik descubrió que hacer bien este proceso era más importante que cualquier otro aspecto del propio modelo.
¿Cómo evitan los equipos antifraude que los agentes de IA para la detección del fraude se descontrolen?
La respuesta breve es que cada agente debe tener un responsable. En Imprint, cada agente tiene asignada una persona concreta que responde por lo que hace. En Intuit, el equipo de Karthik supervisa en tiempo real el grado de coincidencia entre la IA y los revisores humanos. Si la discrepancia aumenta demasiado, se reduce la actividad del agente o se suspende hasta que el equipo averigüe qué ha fallado. En Slope, Lawrence gestiona deliberadamente la plataforma interna de agentes a través de canales públicos de Slack. Así, los ingenieros pueden detectar abiertamente una respuesta incorrecta y todo el equipo desarrolla un criterio compartido sobre cómo debe ser una respuesta correcta. La supervisión de los agentes antifraude no es algo que se configura una vez y se deja funcionar sin más. Es una responsabilidad operativa continua.
¿Por qué los agentes de IA para la detección de fraude tienden a generar falsos positivos y cómo pueden solucionarlo los equipos?
Si se les deja actuar por su cuenta, los agentes tienden a marcarlo todo como sospechoso. Tanto Karthik como Lalitha señalaron este problema sin que se les preguntara. La solución consiste en recalibrarlos continuamente para que se ajusten a lo que realmente constituye un comportamiento transaccional normal en su negocio concreto. No se trata de una configuración que se realiza una sola vez. Además, la calidad de sus datos de referencia impone un límite infranqueable: si las etiquetas proceden de revisiones menos rigurosas, el agente sencillamente no podrá superarlas, por muy bueno que sea el modelo.
¿En qué se diferencia el funcionamiento de la IA para la evaluación del riesgo de fraude en pymes de la evaluación tradicional del riesgo crediticio?
El método tradicional consistía en pedir a los propietarios de empresas que presentaran documentos financieros para que alguien los revisara manualmente. Era lento y fácil de manipular. El modelo Transformer de Slope obtiene los datos brutos de las transacciones directamente de la banca abierta y los convierte automáticamente en métricas financieras. Sobre este se ejecuta un modelo fundacional que trata cada transacción bancaria como un token y predice qué viene después, del mismo modo que un modelo de lenguaje predice la siguiente palabra. Como se basa en el historial real de transacciones y no en documentos aportados por los propios interesados, es mucho más difícil de falsificar.