

Quando um cliente passa o cartão ou cria uma conta, a equipa de prevenção de fraude tem algumas centenas de milissegundos para decidir se deve permitir que avance. Tradicionalmente, estas equipas têm criado modelos suficientemente rápidos para tomar essa decisão, treinando-os com um grande conjunto de dados próprios de fraude previamente classificados — dados de que muitas empresas em fase inicial ainda não dispõem.
O nosso CEO e cofundador, Soups Ranjan, explorou esse problema numa conversa informal que organizámos com a TypeSafe AI. Conversou com Erik Gafni, CTO e cofundador da TypeSafe AI, com moderação de Yoko Li, sócia da a16z Infra. Os dois centraram a conversa no Jev, o modelo de Sistema 1 da TypeSafe AI, e no que aconteceu quando o integrámos no Sardine Flow. A TypeSafe AI foi buscar essa designação ao termo usado por Daniel Kahneman para descrever o pensamento rápido e intuitivo.
Como o modelo Jev da TypeSafe AI toma decisões de IA rápidas e calibradas
O Jev faz muito bem um tipo de chamada, retornando uma decisão rápida e calibrada que se integra a softwares convencionais como um componente básico. A equipe de Erik o projetou para funcionar em conjunto com o restante do código, de modo que uma aplicação chama o modelo da mesma forma que chamaria qualquer outra função.
Qualquer engenheiro de software pode agora criar um classificador no Jev em segundos. Há alguns anos, uma empresa precisava de uma equipa própria de engenheiros experientes em aprendizagem automática para ajustar um modelo BERT com uma enorme quantidade de exemplos rotulados e obter o mesmo resultado. Acabava por obter uma solução limitada, cujo desempenho se degradava sempre que os dados mudavam. Erik defende que um classificador criado no Jev tem maior capacidade de generalização e, por isso, continua a funcionar quando os padrões de fraude mudam.
Utilizar o Jev para associar nomes a endereços de e-mail e tomar decisões de KYB
Soups apresentou dois problemas da nossa própria avaliação do Jev, começando pela correspondência entre nomes e endereços de e-mail. Usou o seu próprio endereço como exemplo, já que soups@sardine.ai não se parece em nada com o seu nome completo. Os motores de regras tendem a não identificar uma correspondência deste tipo, enquanto os grandes modelos de linguagem (LLMs) só a detetam após vários segundos de raciocínio. O Jev acertou à primeira tentativa, com rapidez suficiente para um fluxo de pagamento em tempo real.
Uma equipe de prevenção a fraudes que espera de dois a quatro segundos pela resposta de um LLM já perdeu a oportunidade de agir durante uma transação com cartão ou o cadastro de um cliente.
Em seguida, Soups passou a falar sobre conheça sua empresa (KYB). No nosso produto de KYB, consultamos de 20 a 30 fontes de dados, incluindo avaliações no Google Maps e no Yelp, para descobrir quem são os proprietários de uma empresa e o que ela realmente faz, incluindo sua verdadeira classificação setorial. Antes, os clientes ajustavam manualmente sua própria pontuação, que transformava todas essas evidências em uma decisão de aprovar ou recusar o cadastro. Nossa equipe dedicava muitas horas a ajudá-los a acertar esses ajustes.
Esses clientes podem agora delegar essa última etapa ao Jev sem necessidade de qualquer ajuste. O Jev também funciona como um nó no Sardine Flow, a nossa ferramenta de criação de fluxos de trabalho para setores regulamentados.
A automatização da verificação de sanções começa com um procedimento operacional padrão por escrito
Soups argumentou que uma empresa com um procedimento operacional padrão (SOP) documentado raramente precisa de um agente de IA para redescobrir seus critérios de decisão. Ele prefere que as equipes criem seus fluxos de trabalho em uma ferramenta como Sardine Flow, n8n ou LangChain e incluam um modelo de decisão nas etapas que exigem discernimento. Para explicar o motivo, usou como exemplo a verificação de sanções, citando uma fintech de destaque que trata seus alertas de sanções com um SOP de dez páginas. Soups converteria todas as dez páginas em um fluxo de trabalho, que é mais rápido e custa menos do que deixar agentes improvisarem ao longo do processo.
Muitos bancos e fintechs nunca documentaram os seus procedimentos. Os seus analistas mais experientes têm o procedimento real apenas na cabeça. Erik perguntou se uma operação sem um procedimento operacional padrão (POP) documentado poderia funcionar sem que uma pessoa revisse cada decisão, e Soups destacou quantas empresas já funcionam assim atualmente. Essas equipas precisam de documentar o POP antes de poderem pôr um modelo a trabalhar com base nele.
Assim que o fizerem, podem começar a automatizar grande parte do trabalho de análise. Soups estima que cerca de 30% dos funcionários de um banco realizam análises manuais. Muitos desses analistas passam os dias a descartar falsos positivos nas listas de sanções. Um analista que esteja a analisar um cliente chamado Osama, por exemplo, tem de confirmar que não se trata de Osama bin Laden, verificando a data de nascimento, o local de nascimento e a morada do cliente antes de descartar a correspondência.
Desenvolvemos um motor de IA que incorpora os procedimentos operacionais padrão de um banco precisamente para este tipo de trabalho. Em alguns bancos, já automatiza cerca de 90% das análises de sanções, e registámos uma precisão de 100% ao longo de seis meses de funcionamento. O Centro de Serviços Financeiros da Deloitte registou ganhos de automação semelhantes em bancos de primeira linha que utilizam a aprendizagem automática na análise de sanções. Conseguimos estes resultados ao garantir, inicialmente, a revisão humana de todos os casos e, depois, ao reduzir gradualmente essa revisão de 100% para 10% dos casos, à medida que o motor demonstrava a sua fiabilidade.
Treinar um classificador de fraude sem dados rotulados
Em implementações reais, a falta de rótulos é o obstáculo com que mais nos deparamos. Se um cliente pudesse indicar a Soups quais das empresas que integrou na sua plataforma se revelaram fraudulentas, ele poderia treinar um classificador com base nesse histórico. Um cliente que esteja a começar do zero não tem nada disso para fornecer. Nesse caso, Soups recorreria a um modelo do Sistema 1, uma vez que esse cliente continua a ter de tomar decisões e prefere não encarregar os seus cientistas de dados de ajustar pesos.
Uma pessoa da plateia perguntou como uma equipe poderia detectar campanhas fraudulentas de forma agregada sem nenhum dado rotulado. Os participantes do painel descreveram um ciclo de feedback. Jev faz a avaliação inicial. Em seguida, um operador humano a revisa, aprovando ou reprovando a decisão, e esse retorno é usado para treinar novamente o modelo. Com o tempo, o operador vai criando os rótulos que o cliente nunca teve.
Por que os modelos sem estado tornam as decisões sobre fraude consistentes e explicáveis
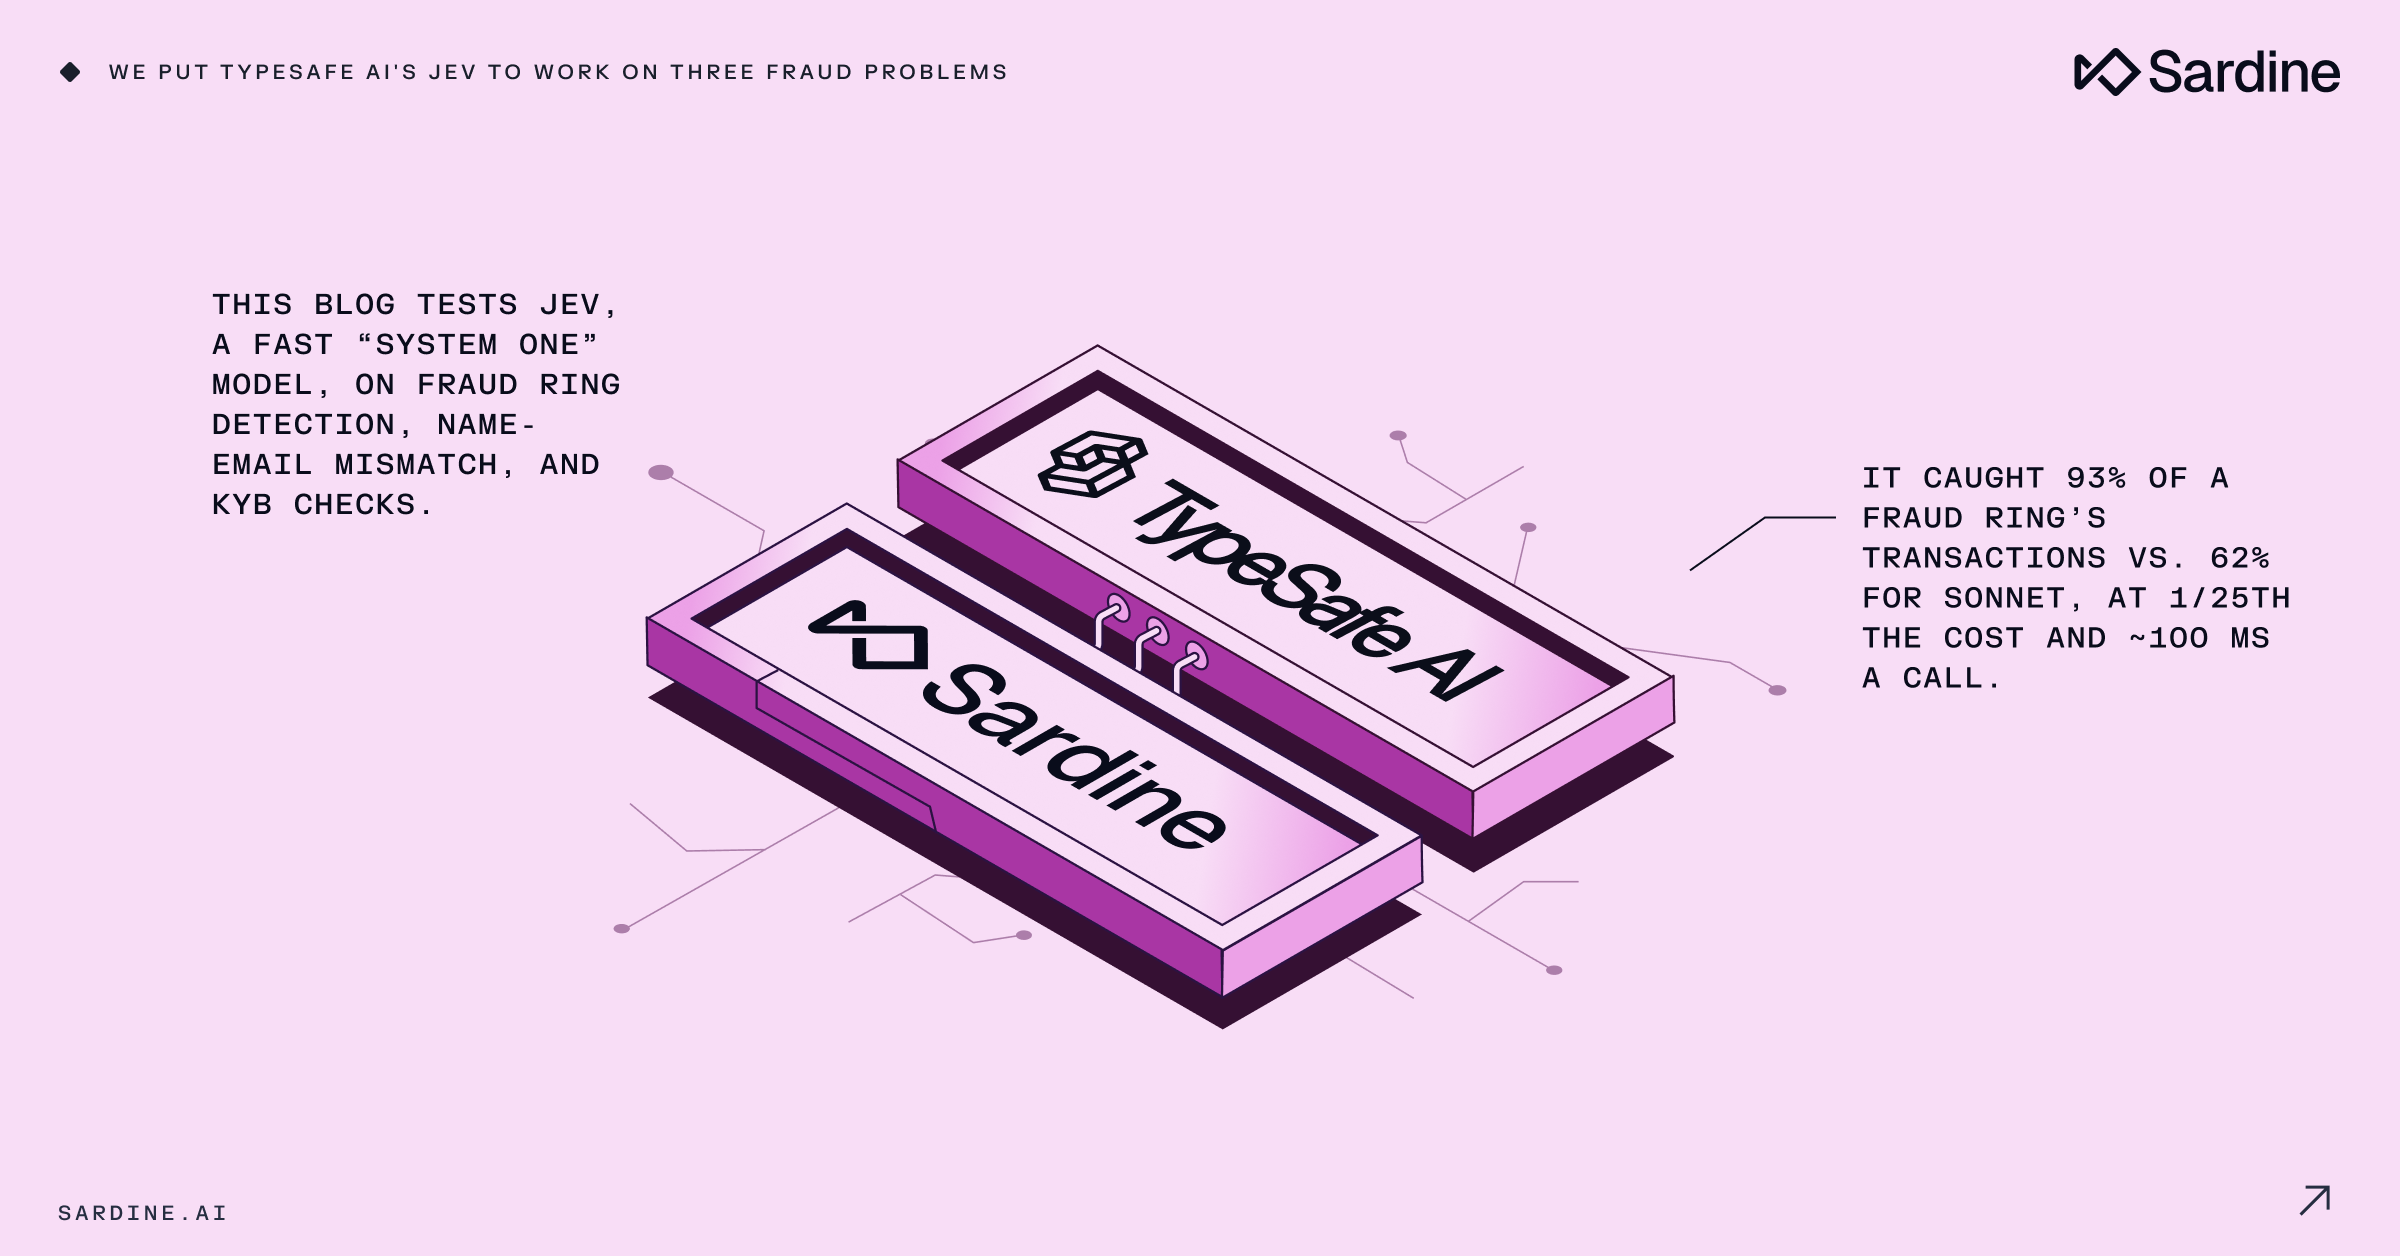
O Jev não mantém estado, por isso os engenheiros fornecem todo o contexto a cada chamada. Soups testou o Jev num caso real de uma rede de fraude, em que os fraudadores operavam várias contas com cartões, endereços e números de telefone partilhados. Forneceu ao Claude Opus e ao Jev o grafo da rede e o histórico de transações. O Jev identificou todas as transações da sequência como fraudulentas, uma conclusão a que o Opus nunca chegou com os mesmos dados.
Soups fez questão de salientar que se tratava de um único teste sobre um único evento. Ainda assim, o resultado está alinhado com o que as equipas de serviços financeiros precisam de um modelo. Os bancos querem uma resposta rápida e de baixo custo que possam reproduzir na próxima consulta, e Erik dedicou grande parte da conversa a essa reprodutibilidade.
Erik salientou que, se fizerem a mesma pergunta dez vezes a um LLM pequeno, este muitas vezes mudará de resposta ou parecerá demasiado seguro de si. Atribui o problema à aprendizagem por reforço com feedback humano (RLHF), que recompensa o modelo por dar respostas de que as pessoas gostam. A TypeSafe AI treina o Jev para melhorar a sua calibração com um método a que chama RLCD. A equipa de Erik também eliminou a interface de chat, o que retira grande parte da pressão que faz aumentar a variabilidade.
Os engenheiros que desenvolvem sistemas com base num modelo sem estado assumem a responsabilidade pela engenharia de contexto. Erik recomenda dividir o sistema em pequenas decisões, cada uma executada localmente, com o software a funcionar como uma máquina de estados em torno do modelo. Ele prefere analisar essas pequenas decisões a ler um longo registo de raciocínio, que pode até contradizer a própria decisão final do modelo.
Erik visualiza cada decisão como um circuito de microdecisões. Um engenheiro pode examinar a questão em cada nó, alterar um limiar no código e reprocessar dados históricos para ver como a edição de um único caractere altera as probabilidades. Erik também recorreu ao reprocessamento para responder a uma pergunta do público sobre o desvio do modelo. Os titulares de cartões podem contestar cobranças semanas após uma transação, por isso os engenheiros não podem esperar por esses dados para detetar desvios no modelo. Em vez disso, podem reprocessar os dados históricos com um nó ajustado e verificar de imediato o efeito da alteração.
A TypeSafe AI também treina o Jev para que o estado e as regras definidos nos dados de entrada prevaleçam sempre que as instruções de um cliente entrem em conflito com o que o Jev aprendeu na Internet durante o treino.
Detetar fraudes de agentes de IA e contas falsas pelos indícios que deixam
Soups defendeu que todo adversário acaba deixando algum indício que o denuncia. Ele citou os agentes de compras com IA usados no comércio agêntico, que leem a estrutura da página de um lojista e clicam no centro exato de cada campo sem sequer mover o mouse. Os fraudadores que adicionam movimentos do mouse aos seus agentes ainda geram movimentos sem a variação natural de uma mão humana. Soups quer que imitar um ser humano se torne exponencialmente mais caro para quem age de má-fé. Os que continuam tentando acabam cometendo um deslize e deixando um indício que os denuncia. No comércio agêntico, nosso protocolo No Human verifica a identidade humana por trás de um agente de compras com IA.
A TypeSafe AI também enfrentou fraudes no lançamento, quando ofereceu créditos gratuitos e os fraudadores começaram a criar contas falsas para obtê-los. A equipa de Erik suspendeu a oferta, já que o acesso gratuito é precisamente o que alguém precisa para destilar um modelo de ponta e criar a sua própria cópia. Estamos a observar fraudadores a usar a mesma estratégia contra outras empresas nativas de IA, provocando um aumento acentuado das fraudes com tokens.
Soups observa as mesmas táticas nos próprios processos de contratação da Sardine, nos quais 75% dos candidatos a vagas de IA e aprendizado de máquina usam perfis falsos, VPNs, números VoIP ou deepfakes. Uma pessoa da plateia chamou a atenção para a questão do recrutamento e perguntou se alguma das duas empresas poderia ter impedido o ataque à Binance, que começou com um esquema de recrutamento e malware. Soups esclareceu que, embora a Sardine não faça detecção de intrusões, oferecemos verificação de fraudes em candidaturas, que combate a parte do problema relacionada a candidatos falsos. Erik destacou que os engenheiros agora podem analisar seus arquivos de acesso e de log em escala e a baixo custo para identificar padrões suspeitos.
Colocando modelos de decisão para trabalhar na sua infraestrutura de prevenção a fraudes
Se você está integrando um modelo de decisão como o Jev à sua infraestrutura de prevenção a fraudes, comece pelo seu procedimento operacional padrão (SOP) e documente tudo o que ainda está apenas na cabeça dos seus analistas. A partir daí, você pode dividir cada decisão em pequenas perguntas para analisar, ajustar e testar com dados históricos. O Jev é mais indicado para perguntas sem dados rotulados e com limites rigorosos de latência. Seus revisores podem verificar cada decisão no início e, depois, reduzir a supervisão à medida que o modelo demonstrar precisão.
Erik encerrou destacando como é difícil executar agentes de LLM em segundo plano milhões de vezes de forma confiável. Mesmo trabalhando com o desenvolvimento de IA, ele dividiria o problema em fluxos determinísticos e deixaria o mínimo possível a cargo do modelo.
Assista à conversa entre a Sardine e a TypeSafe AI quando quiser
Assista à conversa completa com Soups, Erik e Yoko sob demanda aqui.
Perguntas frequentes
O que é um modelo de decisão de fraude e como se enquadra numa arquitetura de modelos de decisão de fraude?
Um modelo de decisão sobre fraude devolve uma decisão rápida e calibrada que uma aplicação pode invocar como qualquer outra função. Numa arquitetura baseada num modelo de decisão sobre fraude, este trata das etapas que exigem discernimento, enquanto o restante fluxo de trabalho se mantém determinístico. Um motor de regras tende a não detetar correspondências, como a associação entre um nome e um endereço de e-mail, algo que o Jev conseguiu fazer com rapidez suficiente para um fluxo de pagamento em tempo real.
Por que as decisões de deteção de fraude sem estado se mantêm consistentes e explicáveis?
Um modelo sem estado não guarda memória entre chamadas, e os engenheiros fornecem-lhe o contexto completo de cada vez, o que coloca a engenharia de contexto nas suas mãos. Erik Gafni, CTO da TypeSafe AI, recomenda desenvolver o software envolvente como uma máquina de estados composta por microdecisões, cada uma executada localmente. As equipas podem analisar cada uma delas e voltar a processar dados históricos depois de alterar um limiar, uma abordagem que ele prefere à leitura de um longo registo de raciocínio.
A verificação de sanções deve ser feita com base num procedimento operacional padrão escrito ou por um agente de IA?
Soups Ranjan defende que uma equipa com um procedimento operacional padrão (SOP) documentado já tem os seus limites de decisão definidos por escrito e pode codificar o procedimento num fluxo de trabalho, acrescentando um modelo de decisão apenas nas etapas que exigem discernimento. Segundo ele, esta abordagem é mais rápida e menos dispendiosa do que deixar os agentes improvisarem, e apresentou como exemplo o SOP de 10 páginas de uma fintech relativo a sanções. As equipas que não têm um SOP documentado precisam de começar por pôr o procedimento por escrito.
O que é um modelo de Sistema 1 para deteção de fraude e por que motivo o Jev é considerado um?
Um modelo de Sistema 1 é concebido para tomar rapidamente um tipo específico de decisão e devolver uma decisão calibrada que outro software possa utilizar diretamente. A TypeSafe AI adotou esta designação a partir do termo usado por Daniel Kahneman para descrever o pensamento rápido e intuitivo. Gafni afirma que um modelo de linguagem de grande escala (LLM) de pequena dimensão, quando confrontado repetidamente com a mesma pergunta, pode mudar de resposta ou demonstrar confiança excessiva. Atribui esse comportamento ao facto de a aprendizagem por reforço com feedback humano (RLHF) recompensar respostas de que as pessoas gostam; a TypeSafe AI, por sua vez, treina o Jev com foco na calibração.
Como criar um classificador de fraudes sem dados rotulados?
A falta de dados rotulados é o obstáculo que a Sardine encontra com mais frequência nas implementações, e uma equipa sem um histórico de fraude confirmada pode começar com um modelo System 1 que toma a decisão inicial. Em seguida, um operador humano revê cada decisão, aprovando-a ou rejeitando-a, e essas avaliações são usadas para voltar a treinar o modelo. Com o tempo, este processo cria os dados rotulados que a equipa nunca teve.