

Cuando un cliente pasa su tarjeta o crea una cuenta, el equipo de prevención del fraude dispone de unos pocos cientos de milisegundos para decidir si le permite continuar. Tradicionalmente, estos equipos han creado modelos lo suficientemente rápidos para tomar esa decisión entrenándolos con grandes conjuntos de datos propios de fraude etiquetados, algo de lo que muchas empresas que están empezando aún no disponen.
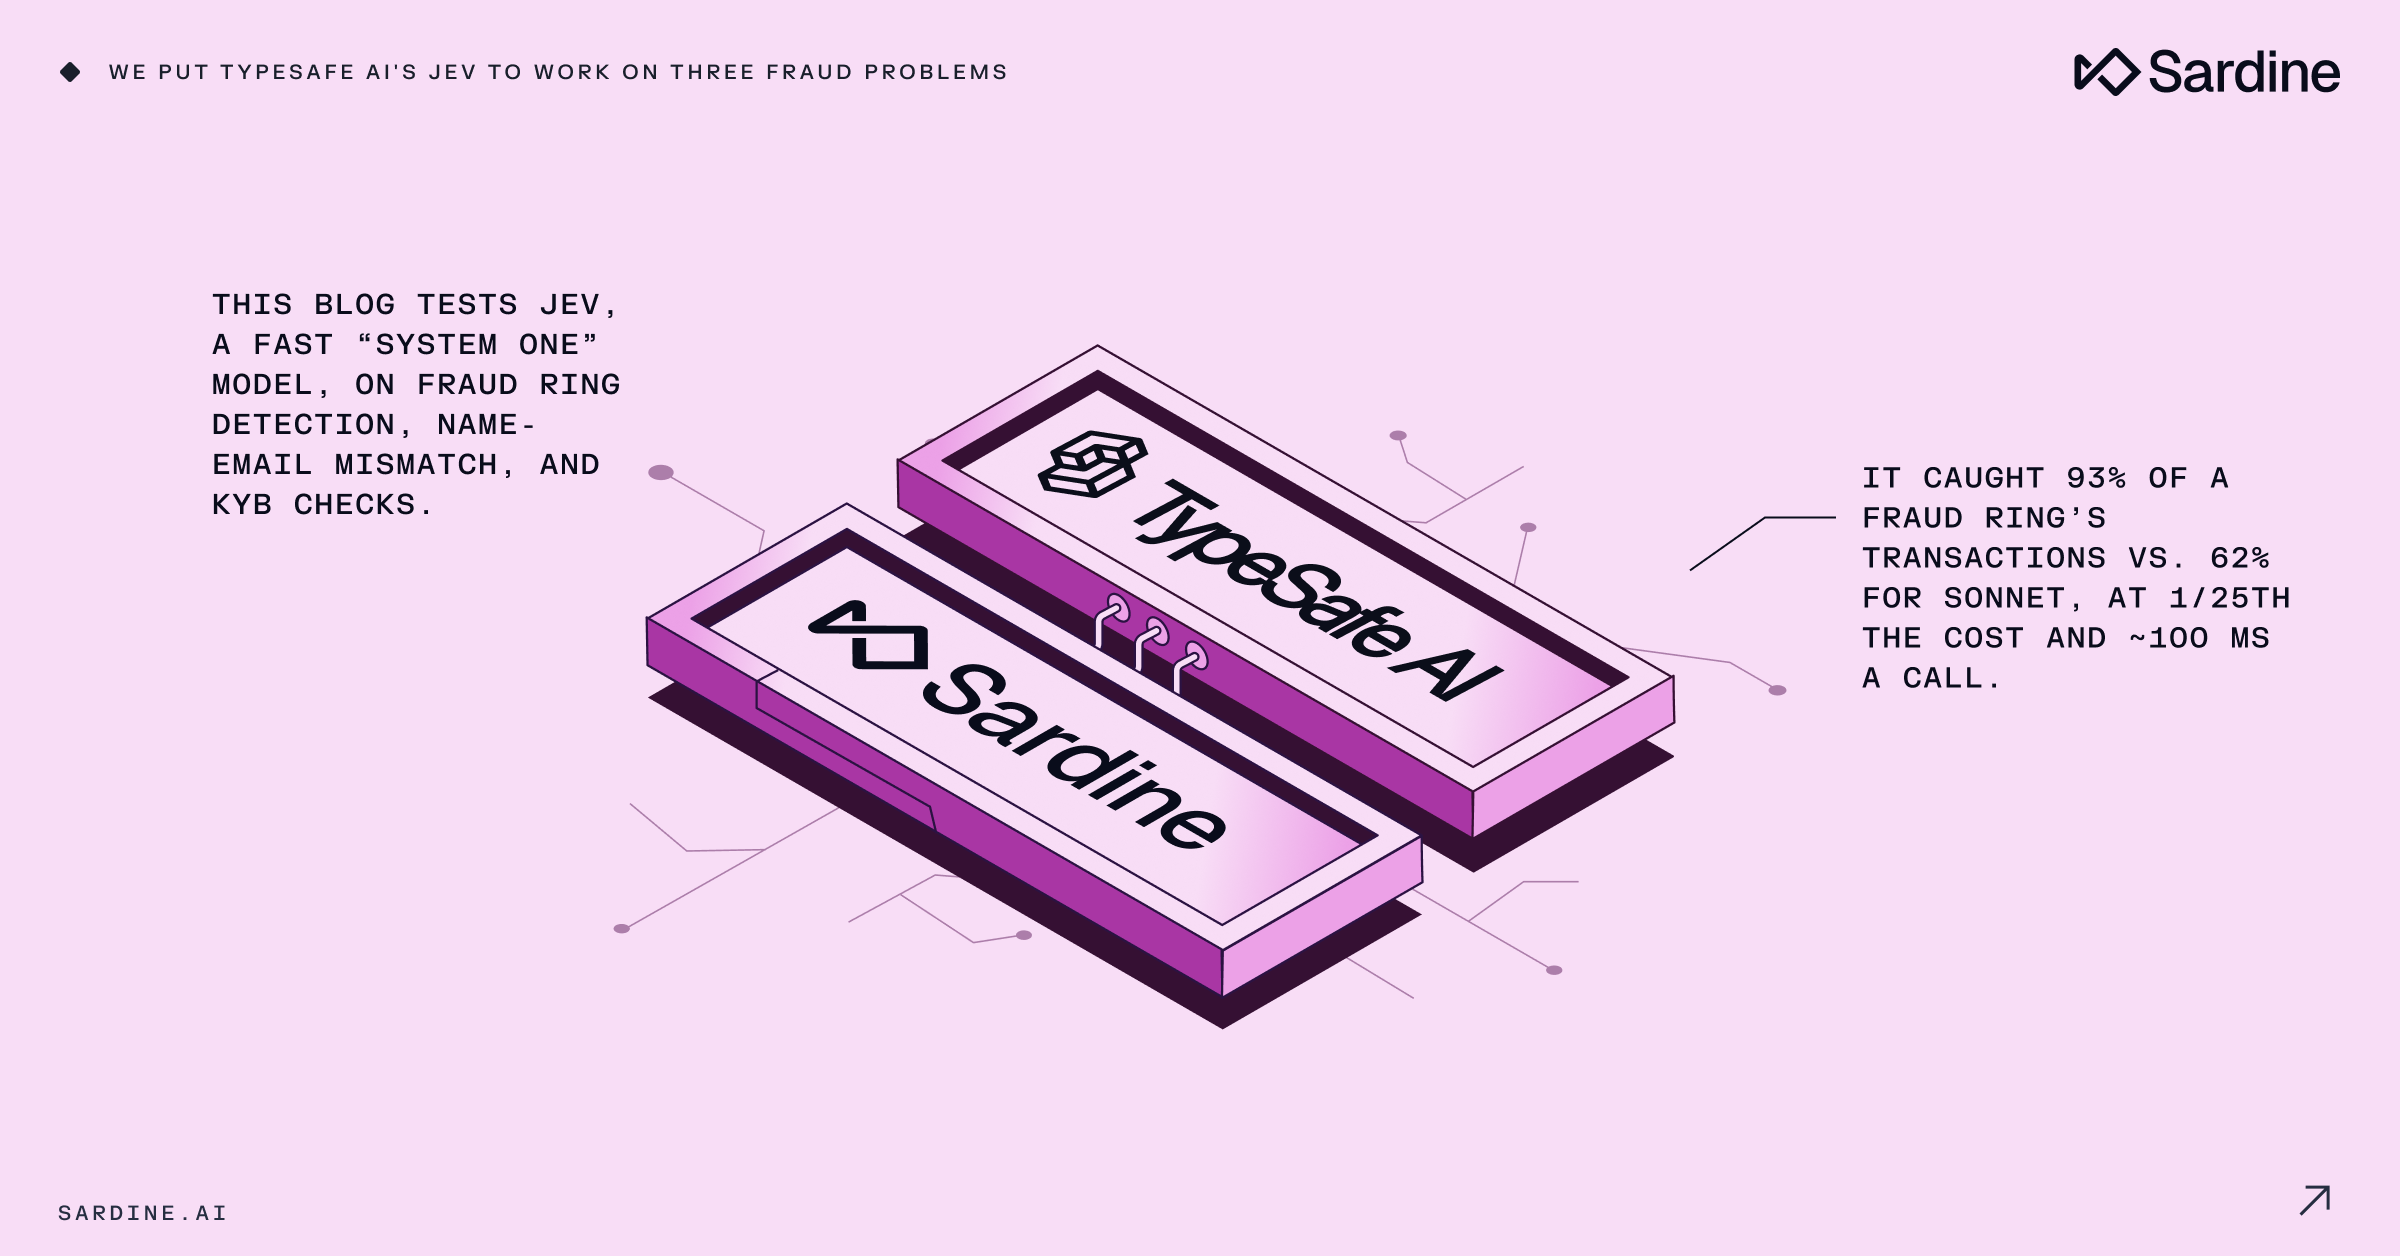
Nuestro CEO y cofundador, Soups Ranjan, profundizó en ese problema durante una charla informal que organizamos con TypeSafe AI. Conversó con Erik Gafni, CTO y cofundador de TypeSafe AI, con Yoko Li, socia de a16z Infra, como moderadora. Ambos centraron la conversación en Jev, el modelo de Sistema 1 de TypeSafe AI, y en lo que ocurrió cuando lo integramos en Sardine Flow. TypeSafe AI tomó el nombre del término que Daniel Kahneman utilizó para describir el pensamiento rápido e intuitivo.
Cómo el modelo Jev de TypeSafe AI toma decisiones de IA rápidas y calibradas
Jev realiza muy bien un tipo concreto de tarea: devuelve una decisión rápida y calibrada que se integra como un componente más en el software convencional. El equipo de Erik lo diseñó para combinarse con el resto del código, de modo que una aplicación invoca el modelo del mismo modo que invocaría cualquier otra función.
Ahora cualquier ingeniero de software puede crear un clasificador en Jev en cuestión de segundos. Hace unos años, para obtener el mismo resultado, una empresa necesitaba su propio equipo de ingenieros con experiencia en aprendizaje automático para ajustar un modelo BERT con una montaña de ejemplos etiquetados. El resultado era una solución de alcance limitado cuyo rendimiento se deterioraba cada vez que cambiaban los datos. Erik sostiene que un clasificador creado en Jev tiene mayor capacidad de generalización, por lo que sigue funcionando cuando cambian los patrones de fraude.
Uso de Jev para vincular nombres con direcciones de correo electrónico y tomar decisiones de KYB
Soups analizó dos problemas de nuestra propia evaluación de Jev, empezando por la correspondencia entre nombres y direcciones de correo electrónico. Utilizó su propia dirección como ejemplo, ya que soups@sardine.ai no se parece en nada a su nombre completo. Los motores de reglas suelen pasar por alto una coincidencia así, mientras que los grandes modelos de lenguaje (LLM) solo la detectan tras varios segundos de razonamiento. Jev acertó a la primera, con la rapidez suficiente para un flujo de pagos en tiempo real.
Un equipo antifraude que espera entre dos y cuatro segundos la respuesta de un LLM ya ha perdido la oportunidad de actuar cuando un cliente paga con tarjeta o se registra.
A continuación, Soups pasó a hablar de conoce a tu empresa (KYB). En nuestro producto KYB, consultamos entre 20 y 30 fuentes de datos, incluidas las reseñas de Google Maps y Yelp, para determinar quién es el propietario de una empresa y a qué se dedica realmente, hasta identificar su verdadera clasificación sectorial. Antes, los clientes ajustaban manualmente su propio sistema de puntuación para convertir toda esa información en una decisión de aceptar o rechazar a la empresa. Nuestro equipo dedicaba muchas horas a ayudarles a afinarlo.
Ahora, esos clientes pueden delegar ese último paso en Jev sin necesidad de realizar ningún ajuste. Jev también funciona como un nodo en Sardine Flow, nuestra herramienta de creación de flujos de trabajo para sectores regulados.
La automatización de la verificación de sanciones comienza con un procedimiento operativo estándar por escrito
Soups sostuvo que una empresa con un procedimiento operativo estándar (SOP) por escrito rara vez necesita un agente de IA que vuelva a descubrir sus criterios de decisión. Preferiría que los equipos crearan su flujo de trabajo en una herramienta como Sardine Flow, n8n o LangChain e incorporaran un modelo de decisión en los pasos que requieren criterio. Para explicar por qué, recurrió al ejemplo de la verificación de sanciones y mencionó una destacada empresa fintech que gestiona sus alertas de sanciones con un SOP de diez páginas. Soups plasmaría esas diez páginas en un flujo de trabajo, que se ejecuta más rápido y cuesta menos que dejar que los agentes vayan improvisando.
Muchos bancos y empresas fintech nunca documentaron sus procedimientos. Son sus analistas sénior quienes tienen el procedimiento real en la cabeza. Erik preguntó si una estructura sin un procedimiento operativo estándar (SOP) por escrito podría llegar a funcionar sin que una persona revisara cada decisión, y Soups señaló cuántas empresas ya operan así hoy en día. Esos equipos tienen que documentar el SOP antes de poder poner un modelo a trabajar con él.
Una vez que lo hagan, podrán empezar a automatizar gran parte de sus tareas de revisión. Soups calcula que alrededor del 30 % de la plantilla de un banco se dedica a la revisión manual. Muchos de esos analistas se pasan el día descartando falsos positivos en las listas de sanciones. Por ejemplo, un analista que revise el caso de un cliente llamado Osama tiene que comprobar su fecha y lugar de nacimiento y su dirección para descartar que se trate de Osama bin Laden y dar por resuelta la coincidencia.
Desarrollamos un motor de IA que incorpora los procedimientos operativos estándar de un banco precisamente para este tipo de trabajo. En algunos bancos, ya automatiza alrededor del 90 % de las revisiones de sanciones, y hemos registrado una precisión del 100 % durante seis meses de funcionamiento. El Centro de Servicios Financieros de Deloitte ha observado avances similares en la automatización en bancos de primer nivel que utilizan el aprendizaje automático para revisar sanciones. Lo logramos asignando al principio a una persona a cada caso y reduciendo después la revisión humana del 100 % de los casos al 10 % a medida que el motor demostraba su fiabilidad.
Entrenar un clasificador de fraude sin datos etiquetados
En implementaciones reales, la falta de etiquetas es el obstáculo con el que nos encontramos con más frecuencia. Si un cliente pudiera indicarle a Soups cuáles de las empresas que ha incorporado resultaron ser fraudulentas, él podría entrenar un clasificador con ese historial. Un cliente que empieza de cero no tiene nada parecido que ofrecer. En ese caso, Soups recurriría a un modelo de Sistema 1, ya que ese cliente sigue teniendo que tomar decisiones y preferiría no tener que dedicar a sus científicos de datos a ajustar los pesos.
Una persona del público preguntó cómo podía un equipo detectar campañas fraudulentas de forma agregada sin contar con datos etiquetados. Los panelistas describieron un ciclo de retroalimentación. Jev toma la decisión inicial. Después, un operador humano la revisa y la aprueba o rechaza, y esa valoración se utiliza para volver a entrenar el modelo. Con el tiempo, el operador va generando las etiquetas de las que el cliente carecía.
Por qué los modelos sin estado permiten tomar decisiones coherentes y explicables sobre el fraude
Jev no conserva el estado, por lo que los ingenieros le proporcionan todo el contexto en cada llamada. Soups puso a prueba a Jev con un caso real de una red de fraude, en el que los estafadores operaban varias cuentas que compartían tarjetas, direcciones y números de teléfono. Les proporcionó a Claude Opus y a Jev el grafo de la red y su historial de transacciones. Jev marcó todas las transacciones de la secuencia como fraudulentas, una conclusión a la que Opus nunca llegó con los mismos datos.
Soups no tardó en señalar que se trataba de una sola prueba sobre un único caso. Aun así, el resultado encaja con lo que los equipos de servicios financieros necesitan de un modelo. Los bancos quieren una respuesta rápida y económica que puedan reproducir la próxima vez que hagan la misma consulta, y Erik dedicó buena parte de la charla a esa reproducibilidad.
Erik señaló que, si se le hace la misma pregunta diez veces a un LLM pequeño, este suele cambiar de respuesta o mostrarse demasiado seguro de sí mismo. Atribuye el problema al aprendizaje por refuerzo a partir de la retroalimentación humana (RLHF), que recompensa al modelo por dar respuestas que gustan a la gente. TypeSafe AI entrena a Jev para que ajuste su grado de confianza a la precisión de sus respuestas mediante un método que denominan RLCD. El equipo de Erik también eliminó la interfaz de chat, lo que reduce en gran medida la presión que hace aumentar la variabilidad.
Los ingenieros que desarrollan sobre un modelo sin estado se encargan ellos mismos de la ingeniería de contexto. Erik recomienda dividir el sistema en pequeñas decisiones que se ejecuten de forma local, con el software actuando como una máquina de estados en torno al modelo. Prefiere examinar esas pequeñas decisiones a leer un largo registro de razonamiento, que incluso puede contradecir la decisión final del propio modelo.
Erik concibe cada decisión como un circuito de microdecisiones. Un ingeniero puede examinar la pregunta en cada nodo, modificar un umbral en su código y volver a procesar los datos históricos para ver cómo cambia la distribución de probabilidades al editar un solo carácter. Erik también utilizó este reprocesamiento para responder a una pregunta del público sobre la deriva del modelo. Los titulares de tarjetas pueden solicitar un contracargo semanas después de una transacción, por lo que los ingenieros no pueden esperar a recibir esos datos para detectar la deriva de su modelo. En su lugar, pueden volver a procesar los datos históricos con un nodo ajustado y comprobar de inmediato el efecto del cambio.
TypeSafe AI también entrena a Jev para que prevalezcan el estado y las reglas definidos en la entrada siempre que las instrucciones de un cliente entren en conflicto con lo que Jev aprendió de internet durante su entrenamiento.
Detectar el fraude de agentes de IA y las cuentas falsas por los indicios que dejan
Soups sostuvo que todo adversario acaba dejando alguna pista que lo delata. Puso como ejemplo a los agentes de compra con IA que hacen posible el comercio agéntico: leen la estructura de la página de un comerciante y hacen clic en el centro exacto de cada campo sin mover el ratón en absoluto. Los estafadores que incorporan movimientos del ratón a sus agentes siguen generando movimientos que carecen de la variabilidad natural de una mano humana. Soups quiere que imitar a un ser humano resulte exponencialmente más costoso para los actores maliciosos. Quienes siguen intentándolo acaban cometiendo un desliz y dejando una pista que los delata. En el comercio agéntico, nuestro protocolo No Human verifica la identidad humana que hay detrás de un agente de compra con IA.
TypeSafe AI también sufrió fraude en su lanzamiento, cuando ofreció créditos gratuitos y los estafadores empezaron a crear cuentas falsas para obtenerlos. El equipo de Erik retiró la oferta, ya que el acceso gratuito es justo lo que se necesita para destilar un modelo de vanguardia y crear una copia propia. Estamos viendo cómo los estafadores recurren a la misma táctica contra otras empresas nativas de IA, lo que está disparando el fraude de tokens.
Soups observa las mismas tácticas en los procesos de contratación de Sardine, donde el 75 % de los candidatos a puestos de IA y aprendizaje automático utilizan perfiles falsos, VPN, números de VoIP o deepfakes. Una persona del público retomó el tema de la contratación y preguntó si alguna de las dos empresas podría haber detenido el hackeo de Binance, que comenzó con una estafa de reclutamiento y malware. Soups dejó claro que, aunque Sardine no se dedica a la detección de intrusiones, sí ofrecemos verificación de fraude en candidaturas, que aborda la parte del problema relacionada con los candidatos falsos. Erik señaló que ahora los ingenieros pueden analizar sus archivos de acceso y de registro a bajo coste y a gran escala para detectar patrones sospechosos.
Cómo integrar los modelos de decisión en tu conjunto de herramientas antifraude
Si vas a incorporar un modelo de decisión como Jev a tu conjunto de herramientas de prevención del fraude, empieza por tus procedimientos operativos estándar y documenta todo lo que aún solo está en la cabeza de tus analistas. A partir de ahí, puedes descomponer cada decisión en pequeñas preguntas que podrás examinar, ajustar y volver a evaluar con datos históricos. Jev resulta especialmente útil para las preguntas sin etiquetas y con un margen de latencia muy limitado. Al principio, tus revisores pueden comprobar cada decisión y, a medida que el modelo demuestre su precisión, reducir su intervención.
Erik concluyó señalando lo difícil que es ejecutar agentes basados en LLM de forma fiable en segundo plano millones de veces. Incluso dedicándose profesionalmente al desarrollo de IA, él descompondría el problema en flujos deterministas y delegaría en el modelo lo mínimo posible.
Mira la charla entre Sardine y TypeSafe AI cuando quieras
Mira la conversación completa con Soups, Erik y Yoko aquí cuando quieras.
Preguntas frecuentes
¿Qué es un modelo de decisión sobre fraude y qué lugar ocupa en una arquitectura de modelos de decisión sobre fraude?
Un modelo de decisión antifraude devuelve rápidamente una decisión calibrada que una aplicación puede solicitar como si llamara a cualquier otra función. Dentro de la arquitectura de un modelo de decisión antifraude, se encarga de los pasos que requieren criterio, mientras que el resto del flujo de trabajo sigue siendo determinista. Un motor de reglas tiende a pasar por alto coincidencias, como la correspondencia entre un nombre y una dirección de correo electrónico, que Jev resolvió con suficiente rapidez para un flujo de pago en tiempo real.
¿Por qué las decisiones sobre fraude sin estado se mantienen coherentes y explicables?
Un modelo sin estado no conserva memoria entre llamadas, por lo que los ingenieros le proporcionan el contexto completo en cada ocasión y tienen así el control de la ingeniería de contexto. Erik Gafni, director de tecnología de TypeSafe AI, recomienda desarrollar el software que lo rodea como una máquina de estados compuesta por microdecisiones que se ejecutan de forma local. Los equipos pueden examinar cada una de ellas y volver a procesar datos históricos tras modificar un umbral, un enfoque que él prefiere a leer un extenso registro de razonamiento.
¿Debería encargarse del control de sanciones un procedimiento operativo estándar por escrito o un agente de IA?
Soups Ranjan sostiene que un equipo que cuenta con un procedimiento operativo estándar (SOP) por escrito ya tiene documentados los límites de sus decisiones y puede plasmar el procedimiento en un flujo de trabajo, incorporando un modelo de decisión solo en los pasos que requieren criterio. Según él, este enfoque es más rápido y menos costoso que dejar que los agentes improvisen, y puso como ejemplo el SOP de 10 páginas de una empresa fintech para la gestión de sanciones. Los equipos que no disponen de un SOP por escrito deben empezar por documentar el procedimiento.
¿Qué es un modelo de Sistema 1 para la detección del fraude y por qué se considera que Jev es uno de ellos?
Un modelo de Sistema 1 está diseñado para tomar rápidamente un tipo concreto de decisión y devolver una decisión calibrada que otro software pueda utilizar directamente. TypeSafe AI tomó el nombre del término que Daniel Kahneman acuñó para el pensamiento rápido e intuitivo. Gafni afirma que un modelo de lenguaje de gran tamaño (LLM) pequeño puede cambiar de respuesta o mostrar un exceso de confianza cuando se le hace la misma pregunta repetidamente. Lo atribuye a que el aprendizaje por refuerzo a partir de comentarios humanos (RLHF) recompensa las respuestas que gustan a las personas; TypeSafe AI, en cambio, entrena a Jev para que sus respuestas estén calibradas.
¿Cómo se crea un clasificador de fraude sin datos etiquetados?
La falta de datos etiquetados es el obstáculo que Sardine encuentra con más frecuencia en sus implementaciones, y un equipo sin un historial de fraude confirmado puede empezar con un modelo System 1 que tome la decisión inicial. Después, una persona revisa cada decisión y la aprueba o rechaza; estas valoraciones se utilizan para volver a entrenar el modelo. Con el tiempo, este proceso genera los datos etiquetados de los que el equipo carecía.